
記事のマーキングは、新聞をオンライン化する作業でいちばん時間のかかる工程です。編集者は読者がクリックできるよう記事ごとに枠を描き、見出しと本文を入力したり貼り付けたりします。しかし印刷所に送ったPDFには、すべての文字とその正確な位置がすでに入っています。Inkfold 1.1ではこの座標を使います。枠を描けば、見出しと本文が自動で入ります。
ブラウザでテキストを読み取る
InkfoldはもともとPDFをブラウザ上でpdf.jsを使って取り込み、各ページを画像に変換していたので、サーバーに追加のソフトウェアは不要でした。同じライブラリは getTextContent() でテキストレイヤーも提供します。テキスト片の一覧で、それぞれに変換行列と幅があります。各テキスト片の行列にページ表示の変換を掛ければ、ページ上のピクセル位置がわかります。文字サイズは行列の縦方向ベクトルの長さで、テキスト片の上端はベースラインからそのサイズを引いた位置です。
テキスト片は行ではなく断片なので、位置で並べ替え、同じベースライン上(文字の高さの半分以内)にあって水平方向に近いものを1行にまとめます。各行はページサイズに対する比率で保存します。記事エリアと同じ座標系です。そしてページ画像のアップロード直後にサーバーへ送ります。
ツールがあればサーバーでも
大きなPDFはサーバーで変換したいという発行元もあります。サーバーにImagick拡張かGhostscriptがあれば、編集者はPDFをアップロードし、サーバーに150dpiでページを生成させられます。さらにPopplerの pdftotext が入っていれば、-bbox-layout の出力から同じ行座標が得られ、同じ形式にそろえます。これらのツールがなくても、すべてブラウザで動きます。
枠から見出しと本文へ
編集者がエリアを描いたとき、行の選び方は単純です。中心点が枠の中にあるすべての行です。どれが見出しかは推測ではなく文字組みで判断します。エリア内でいちばん高い行の85パーセント以上の高さを持つ行が見出しで、残りが本文です。
新聞の本文は段組みになっているので、行を単純に上から下へ読むと段が混ざってしまいます。そこで行を左端の位置で段にまとめ(許容幅はページ幅の約3.5パーセント)、段を左から右へ、各段を上から下へ読みます。行末でハイフン分割された単語はつなぎ直します。
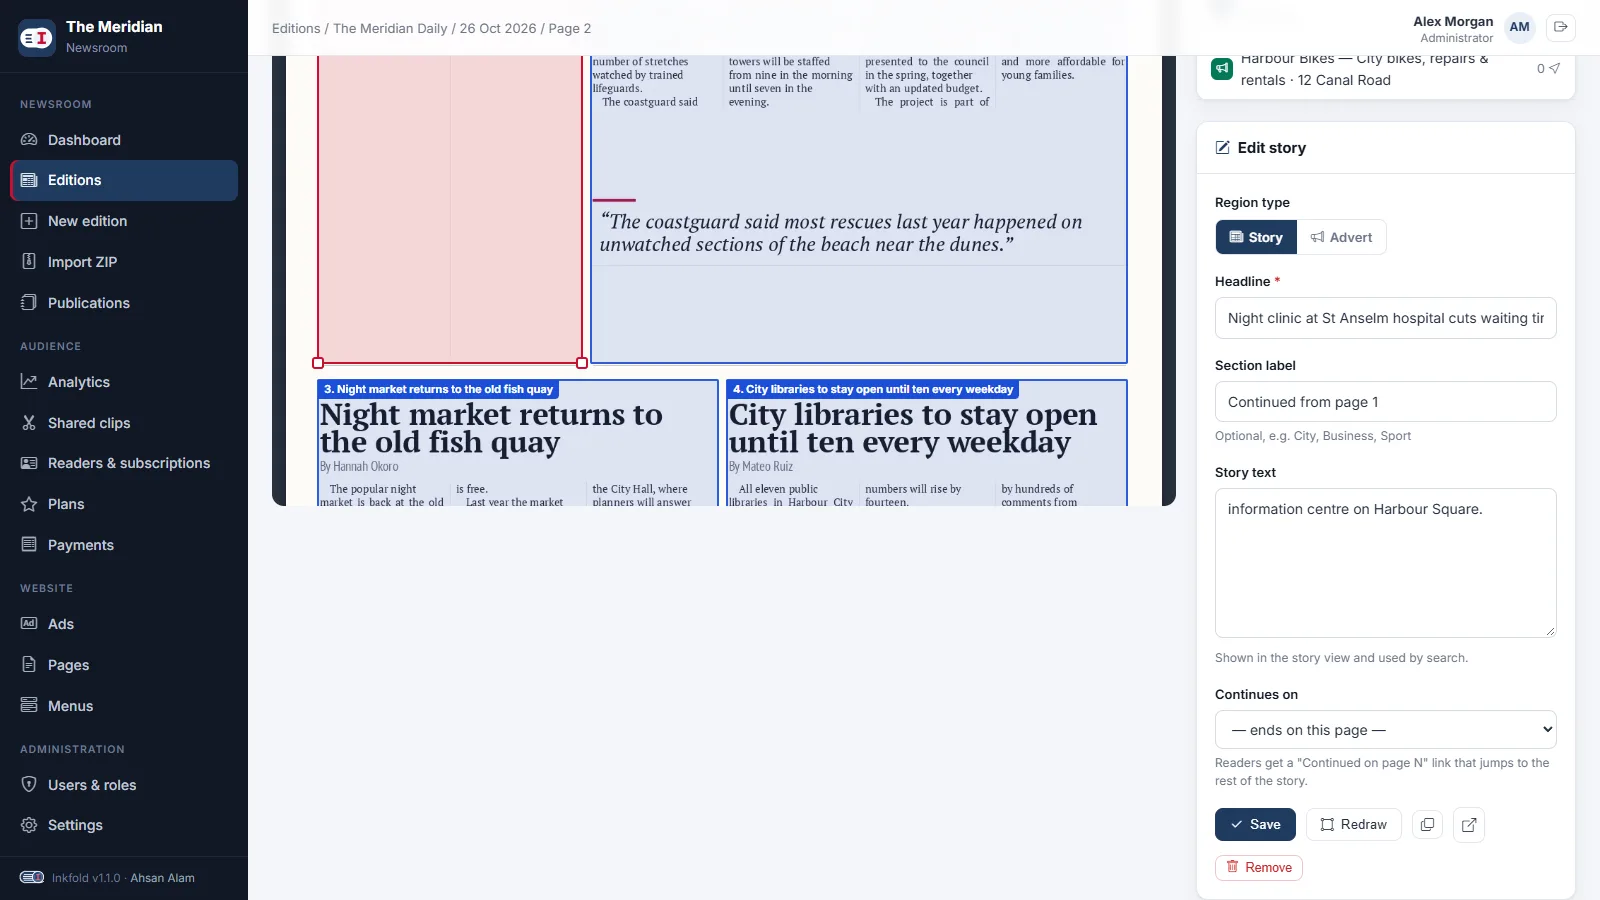
同じロジックを2か所に実装しています。PHP版は本文なしで保存された記事をサーバー側で補完し、JavaScript版は枠を描いた瞬間にマッパーのフォームを埋め、既存の記事には「PDFから入力」ボタンを表示します。ページ全体のテキストも検索用テキストとして保存するので、サイト内検索で広告やキャプションの言葉も見つかります。
ポイント
- 印刷用PDFは構造化データ。打ち直さずにテキストレイヤーを使う。
- 座標はすべてページに対する比率にそろえ、テキストとエリアで同じ座標系を使う。
- 見出しは文字サイズで見分け、本文は段ごとに読む。
- サーバーでの変換は選択肢として提供し、必須にはしない。
シリーズ前回は多言語・右から左対応のリーダーでした。記事マッパーは Inkfoldのデモ の編集画面で試せます。ソフトウェアは Charming Theme で入手できます。
構造化コンテンツにしたいPDF、スキャン画像、印刷データはありませんか?ご相談ください — ArtinTech Solution は出版社向けの文書処理ツールを開発しています。