
Artikel zu markieren ist der langsamste Schritt, um eine Zeitung online zu bringen. Die Redaktion zieht einen Rahmen um jeden Artikel, damit Leser ihn anklicken können, und tippt oder kopiert dann Überschrift und Text. Dabei enthält das PDF, das in die Druckerei ging, bereits jedes Wort mit seiner genauen Position. In Inkfold 1.1 nutzen wir diese Koordinaten: Rahmen ziehen, und Überschrift und Text füllen sich selbst aus.
Den Text im Browser lesen
Inkfold importierte PDFs bereits im Browser mit pdf.js und rendert jede Seite als Bild, der Server braucht also keine Zusatzsoftware. Dieselbe Bibliothek liefert die Textebene über getTextContent(): eine Liste von Textstücken, jedes mit Transformationsmatrix und Breite. Multipliziert man die Matrix jedes Stücks mit der Transformation der Seitenansicht, erhält man seine Position in Seitenpixeln; die Schriftgröße ist die Länge des senkrechten Vektors der Matrix, die Oberkante des Stücks die Grundlinie minus diese Größe.
Textstücke sind Fragmente, keine Zeilen. Wir sortieren sie nach Position und verbinden Nachbarn, die eine Grundlinie teilen (innerhalb einer halben Texthöhe) und waagerecht nah beieinander liegen. Jede Zeile wird als Anteil der Seitengröße gespeichert, im selben Koordinatensystem wie die Artikelbereiche, und direkt nach dem Hochladen des Seitenbildes an den Server geschickt.
Oder auf dem Server, wenn die Werkzeuge da sind
Manche Verlage wandeln große PDFs lieber auf dem Server um. Hat der Server die Imagick-Erweiterung oder Ghostscript, kann die Redaktion das PDF hochladen und die Seiten dort mit 150 dpi rendern lassen. Ist Popplers pdftotext installiert, liefert dessen Ausgabe mit -bbox-layout dieselben Zeilenkoordinaten, die wir ins gleiche Format bringen. Ohne diese Werkzeuge funktioniert weiterhin alles im Browser.
Vom Rahmen zu Überschrift und Text
Zieht die Redaktion einen Bereich, ist die Auswahl der Zeilen einfach: alle Zeilen, deren Mittelpunkt im Rahmen liegt. Welche davon die Überschrift ist, entscheidet die Typografie statt Raten: Zeilen, deren Höhe mindestens 85 Prozent der höchsten Zeile im Bereich beträgt. Alles andere ist Fließtext.
Fließtext läuft in Zeitungen in Spalten; Zeilen streng von oben nach unten zu lesen, würde sie vermischen. Wir gruppieren die Zeilen nach ihrer linken Kante in Spalten, mit einer Toleranz von etwa 3,5 Prozent der Seitenbreite, lesen die Spalten von links nach rechts und jede Spalte von oben nach unten. Trennstriche am Zeilenende werden zusammengefügt, aus „Repa-“ und „ratur“ wird „Reparatur“.
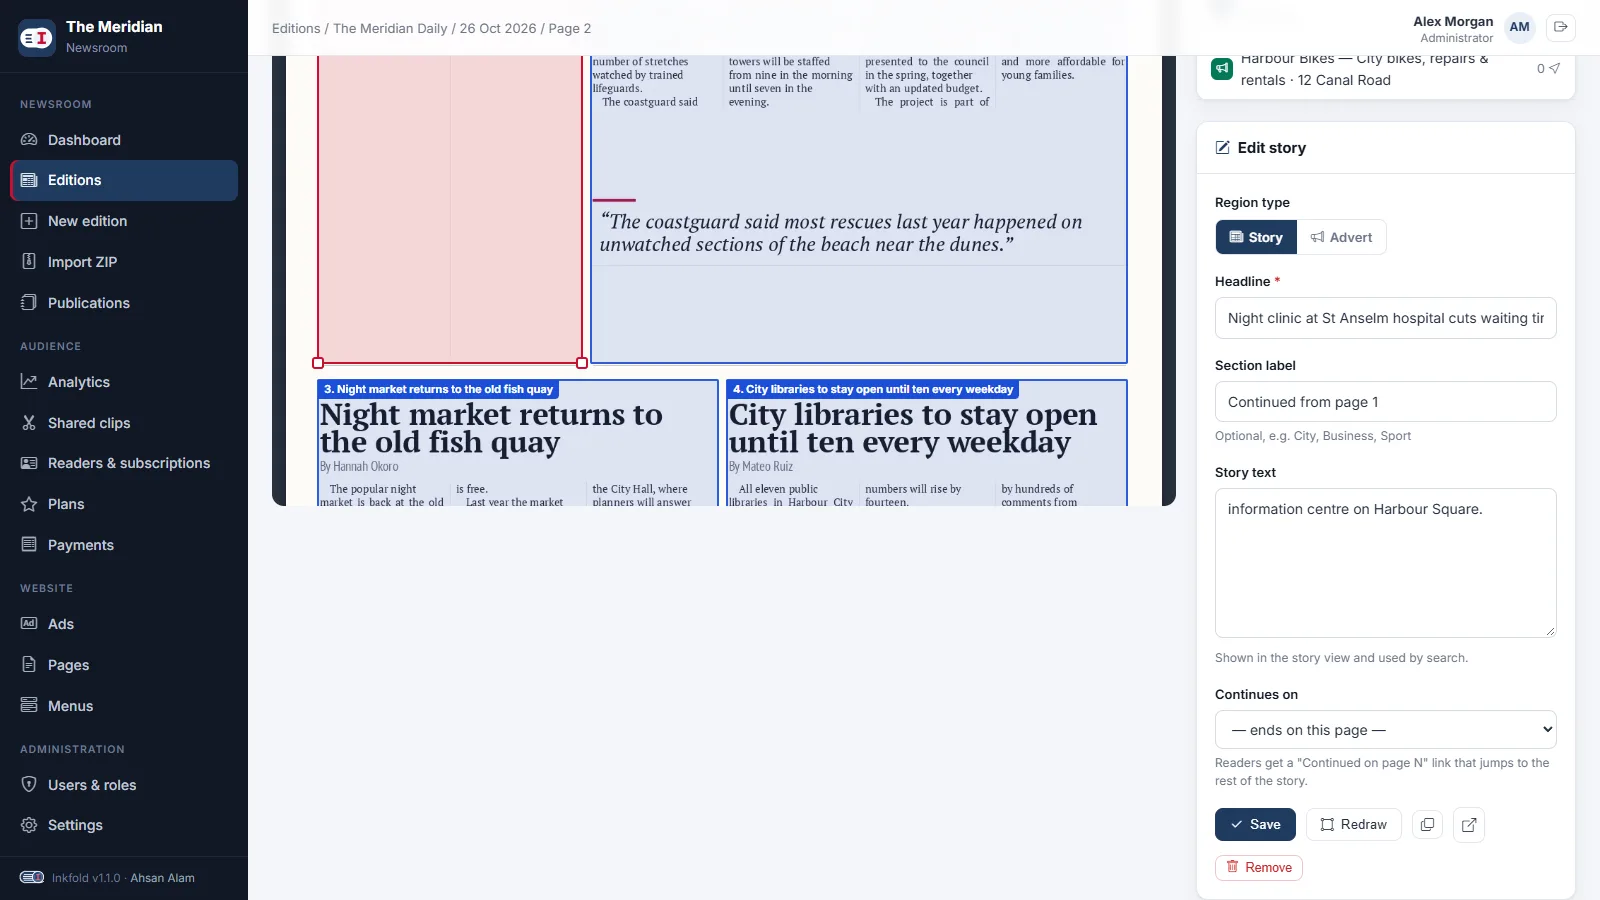
Dieselbe Logik gibt es zweimal: in PHP, damit ein ohne Text gespeicherter Artikel auf dem Server gefüllt wird, und in JavaScript, damit der Mapper das Formular sofort beim Zeichnen ausfüllt und für bestehende Artikel einen Knopf „Aus dem PDF füllen“ anbietet. Der Text der ganzen Seite wird zudem als durchsuchbarer Seitentext gespeichert, sodass die Suche auch Wörter in Anzeigen und Bildunterschriften findet.
Das Wichtigste
- Das Druck-PDF ist strukturierte Information: die Textebene nutzen statt abzutippen.
- Alle Koordinaten auf Anteile der Seite normieren, damit Text und Bereiche ein System teilen.
- Überschriften an der Schriftgröße erkennen und Fließtext Spalte für Spalte lesen.
- Serverseitige Umwandlung als Option anbieten, nie als Voraussetzung.
Zuvor in dieser Reihe: ein mehrsprachiger Reader mit Rechts-nach-links. Probieren Sie den Story-Mapper in der Redaktion der Inkfold-Demo; die Software gibt es bei Charming Theme.
Sie haben PDFs, Scans oder Druckdaten, die zu strukturierten Inhalten werden sollen? Sprechen wir darüber — ArtinTech Solution baut Werkzeuge zur Dokumentverarbeitung für Verlage.