
Marcar las noticias es la parte más lenta de llevar un periódico a internet. Un editor dibuja un recuadro alrededor de cada noticia para que los lectores puedan pulsarla y luego escribe o pega el titular y el texto. Sin embargo, el PDF que fue a imprenta ya contiene cada palabra y su posición exacta. En Inkfold 1.1 usamos esas coordenadas: dibujas el recuadro y el titular y el texto se rellenan solos.
Leer el texto en el navegador
Inkfold ya importaba los PDF en el navegador con pdf.js, convirtiendo cada página en imagen para que el servidor no necesite software adicional. La misma biblioteca expone la capa de texto con getTextContent(): una lista de fragmentos, cada uno con su matriz de transformación y su anchura. Multiplicando la matriz de cada fragmento por la transformación de la vista se obtiene su posición en píxeles de la página; el tamaño de letra es la longitud del vector vertical de la matriz y el borde superior es la línea base menos ese tamaño.
Los fragmentos no son líneas, así que los ordenamos por posición y unimos los vecinos que comparten línea base (con media altura de texto de margen) y están cerca en horizontal. Cada línea se guarda como fracciones del tamaño de la página, el mismo sistema que usan las zonas de noticia, y se envía al servidor justo después de subir la imagen de la página.
O en el servidor, si tiene las herramientas
Algunos editores prefieren convertir los PDF grandes en el servidor. Si el servidor tiene la extensión Imagick o Ghostscript, el editor puede subir el PDF y dejar que el servidor genere las páginas a 150 ppp. Si además está instalado pdftotext de Poppler, su salida -bbox-layout da las mismas coordenadas por línea, que normalizamos al mismo formato. Sin ninguna de estas herramientas, todo sigue funcionando en el navegador.
De un recuadro a un titular y un cuerpo
Cuando el editor dibuja una zona, elegir las líneas es sencillo: todas aquellas cuyo centro cae dentro del recuadro. Para decidir cuáles forman el titular usamos la tipografía, no la intuición: las líneas cuya altura es al menos el 85 % de la línea más alta de la zona. El resto es el cuerpo.
El cuerpo de una noticia va en columnas, y leer las líneas de arriba abajo las mezclaría. Agrupamos las líneas en columnas por su borde izquierdo, con una tolerancia de alrededor del 3,5 % del ancho de la página, y leemos las columnas de izquierda a derecha y cada columna de arriba abajo. Las palabras partidas a final de línea se unen, de modo que «repa-» seguido de «ración» se convierte en «reparación».
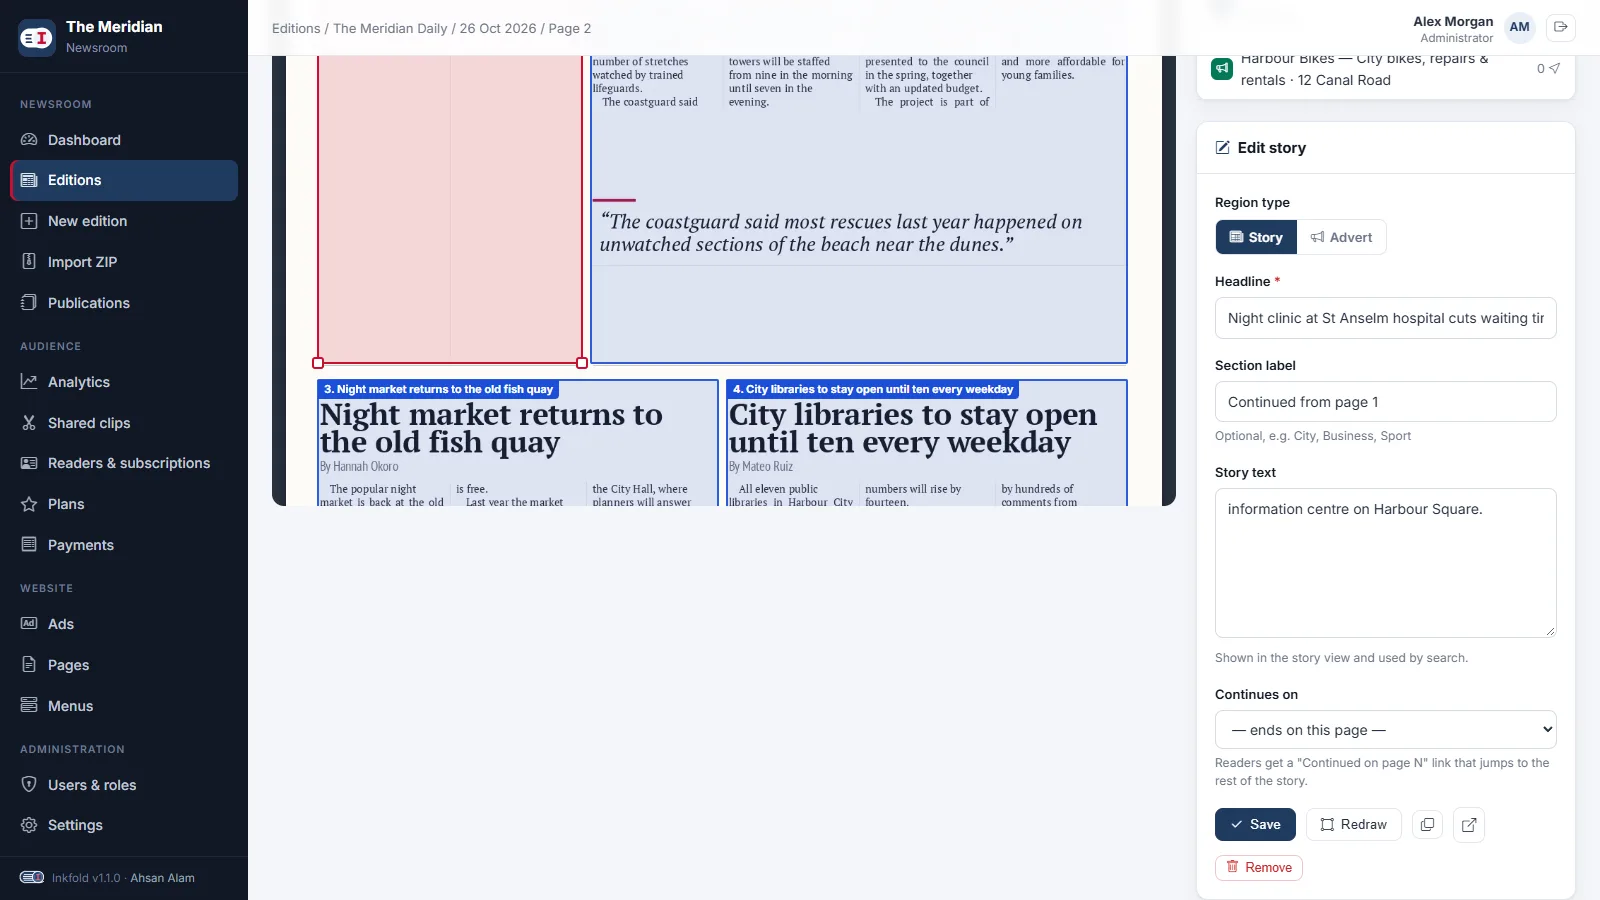
La misma lógica existe dos veces: en PHP, para que una noticia guardada sin texto se rellene en el servidor, y en JavaScript, para que el mapeador rellene el formulario en cuanto se dibuja el recuadro y ofrezca un botón «Rellenar desde el PDF» para noticias existentes. El texto de toda la página se guarda además como texto buscable, de modo que el buscador también encuentra palabras de anuncios y pies de foto.
Ideas clave
- El PDF de imprenta son datos estructurados: usa su capa de texto en lugar de volver a teclear.
- Normaliza todas las coordenadas a fracciones de la página para que texto y zonas compartan sistema.
- Detecta los titulares por el tamaño de letra y lee el cuerpo columna a columna.
- Ofrece la conversión en el servidor como opción, nunca como requisito.
Antes en la serie: un lector multilingüe de derecha a izquierda. Prueba el mapeador en la redacción de la demo de Inkfold; el software está en Charming Theme.
¿Tienes PDF, escaneos o archivos de imprenta que deberían convertirse en contenido estructurado? Hablemos — ArtinTech Solution crea herramientas de procesamiento de documentos para editores.