
Baliser les articles est l’étape la plus lente pour mettre un journal en ligne. Un rédacteur trace un cadre autour de chaque article pour que les lecteurs puissent cliquer dessus, puis tape ou colle le titre et le texte. Pourtant, le PDF parti à l’imprimerie contient déjà chaque mot et sa position exacte. Dans Inkfold 1.1, nous utilisons ces coordonnées : on trace le cadre et le titre et le texte se remplissent tout seuls.
Lire le texte dans le navigateur
Inkfold importait déjà les PDF dans le navigateur avec pdf.js, en transformant chaque page en image pour que le serveur n’ait besoin d’aucun logiciel supplémentaire. La même bibliothèque donne accès à la couche texte avec getTextContent() : une liste de fragments, chacun avec sa matrice de transformation et sa largeur. En multipliant la matrice de chaque fragment par la transformation de la vue, on obtient sa position en pixels de page ; la taille de police est la longueur du vecteur vertical de la matrice, et le haut du fragment est la ligne de base moins cette taille.
Les fragments ne sont pas des lignes : nous les trions par position et regroupons les voisins qui partagent une ligne de base (à une demi-hauteur de texte près) et sont proches horizontalement. Chaque ligne est enregistrée en fractions de la taille de la page, le même système que les zones d’articles, et envoyée au serveur juste après l’envoi de l’image de la page.
Ou sur le serveur, quand les outils sont là
Certains éditeurs préfèrent convertir les gros PDF sur le serveur. Si le serveur dispose de l’extension Imagick ou de Ghostscript, la rédaction peut envoyer le PDF et laisser le serveur produire les pages à 150 dpi. Si pdftotext de Poppler est installé, sa sortie -bbox-layout fournit les mêmes coordonnées de lignes, que nous ramenons au même format. Sans aucun de ces outils, tout fonctionne toujours dans le navigateur.
D’un cadre à un titre et un corps de texte
Quand la rédaction trace une zone, le choix des lignes est simple : toutes celles dont le centre tombe dans le cadre. Pour savoir lesquelles forment le titre, on se fie à la typographie plutôt qu’à l’intuition : les lignes dont la hauteur atteint au moins 85 % de la plus haute ligne de la zone. Le reste est le corps du texte.
Dans un journal, le corps du texte court sur plusieurs colonnes, et lire les lignes strictement de haut en bas les mélangerait. Nous regroupons les lignes en colonnes selon leur bord gauche, avec une tolérance d’environ 3,5 % de la largeur de la page, puis lisons les colonnes de gauche à droite et chacune de haut en bas. Les mots coupés en fin de ligne sont recollés : « répa- » suivi de « ration » devient « réparation ».
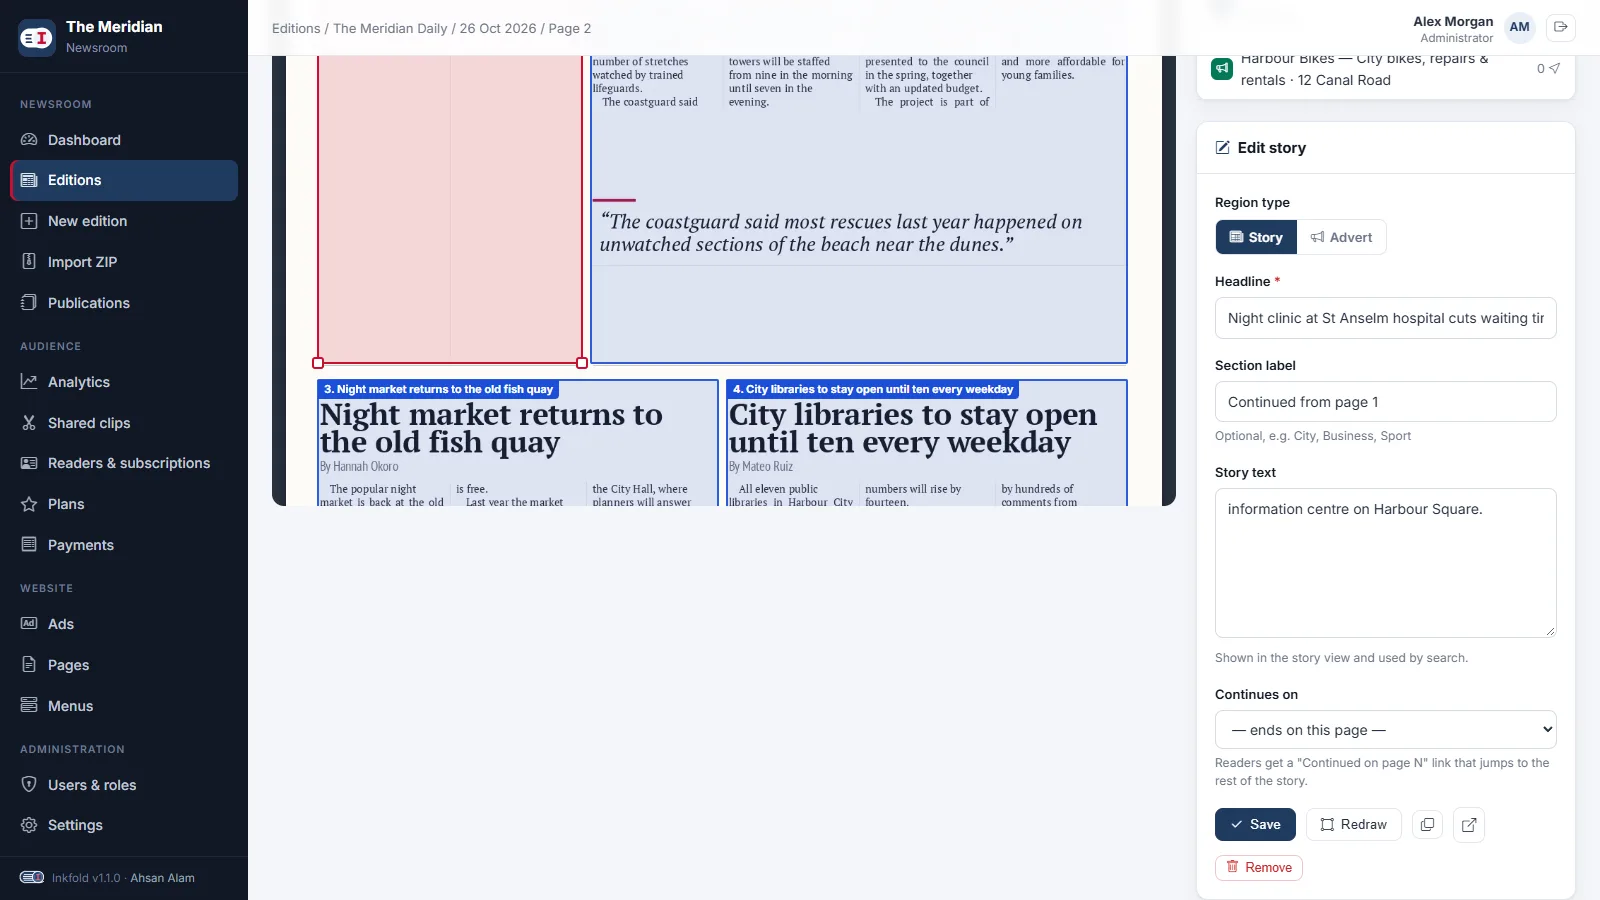
La même logique existe en deux exemplaires : en PHP, pour qu’un article enregistré sans texte soit complété côté serveur, et en JavaScript, pour que l’outil de balisage remplisse le formulaire dès que le cadre est tracé et propose un bouton « Remplir depuis le PDF » pour les articles existants. Le texte de toute la page est aussi enregistré comme texte de recherche : la recherche du site trouve ainsi les mots des publicités et des légendes.
À retenir
- Le PDF d’impression est une donnée structurée : utilisez sa couche texte au lieu de retaper.
- Ramenez toutes les coordonnées à des fractions de la page pour que texte et zones partagent un système.
- Repérez les titres à la taille de police et lisez le corps colonne par colonne.
- Proposez la conversion côté serveur comme option, jamais comme exigence.
Plus tôt dans la série : une liseuse multilingue de droite à gauche. Essayez l’outil de balisage dans la rédaction de la démo Inkfold ; le logiciel est sur Charming Theme.
Vous avez des PDF, des scans ou des fichiers d’impression à transformer en contenu structuré ? Parlons-en — ArtinTech Solution conçoit des outils de traitement de documents pour les éditeurs.