🌐 Lea este artículo en otro idioma: English · Español · Deutsch · Français · Bahasa Melayu · العربية · 简体中文 · 日本語
El web scraping es el proceso de extraer datos de sitios web de forma automática, para investigación, seguimiento de precios, listas de contactos, análisis de mercado o para alimentar sistemas internos. En Python, dos herramientas dominan la conversación: BeautifulSoup y Scrapy.
A menudo se comparan como si fueran competidoras, pero resuelven problemas distintos. BeautifulSoup es una biblioteca para analizar HTML. Scrapy es un framework completo para rastrear sitios web a gran escala. Esta guía explica la diferencia con código real y te ayuda a elegir la herramienta adecuada para tu proyecto.
¿Qué es BeautifulSoup?
BeautifulSoup (el paquete bs4) lee un documento HTML o XML y lo convierte en un árbol que puedes recorrer con métodos sencillos de Python como find(), find_all() y selectores CSS mediante select(). No descarga páginas por sí misma, así que casi siempre se combina con una biblioteca HTTP como Requests.
- Muy fácil de aprender, incluso para principiantes en Python.
- Tolerante con HTML desordenado o mal formado.
- Funciona con distintos analizadores: el
html.parserintegrado, el rápidolxmlohtml5libpara un análisis similar al de un navegador. - Ideal para scripts pequeños y trabajos puntuales.
¿Qué es Scrapy?
Scrapy es un framework de código abierto para crear rastreadores web, llamados spiders. Gestiona todo el flujo de trabajo: enviar peticiones, seguir enlaces, analizar respuestas, limpiar los datos y exportarlos.
- Asíncrono por diseño. Scrapy envía muchas peticiones a la vez, lo que lo hace mucho más rápido en sitios grandes.
- Cortesía integrada. Respetar robots.txt, AutoThrottle, los retardos de descarga y los reintentos son simples ajustes.
- Los item pipelines limpian, validan y guardan los datos en una base de datos o un archivo.
- Las feed exports escriben JSON, CSV o XML con un solo comando.
- Los middlewares te permiten personalizar cabeceras, proxies, caché y gestión de errores.
El mismo scraper con las dos herramientas
El ejemplo siguiente recoge todas las citas y sus autores de quotes.toscrape.com, un sitio creado para practicar scraping. A la izquierda, Requests con BeautifulSoup; a la derecha, un spider de Scrapy.
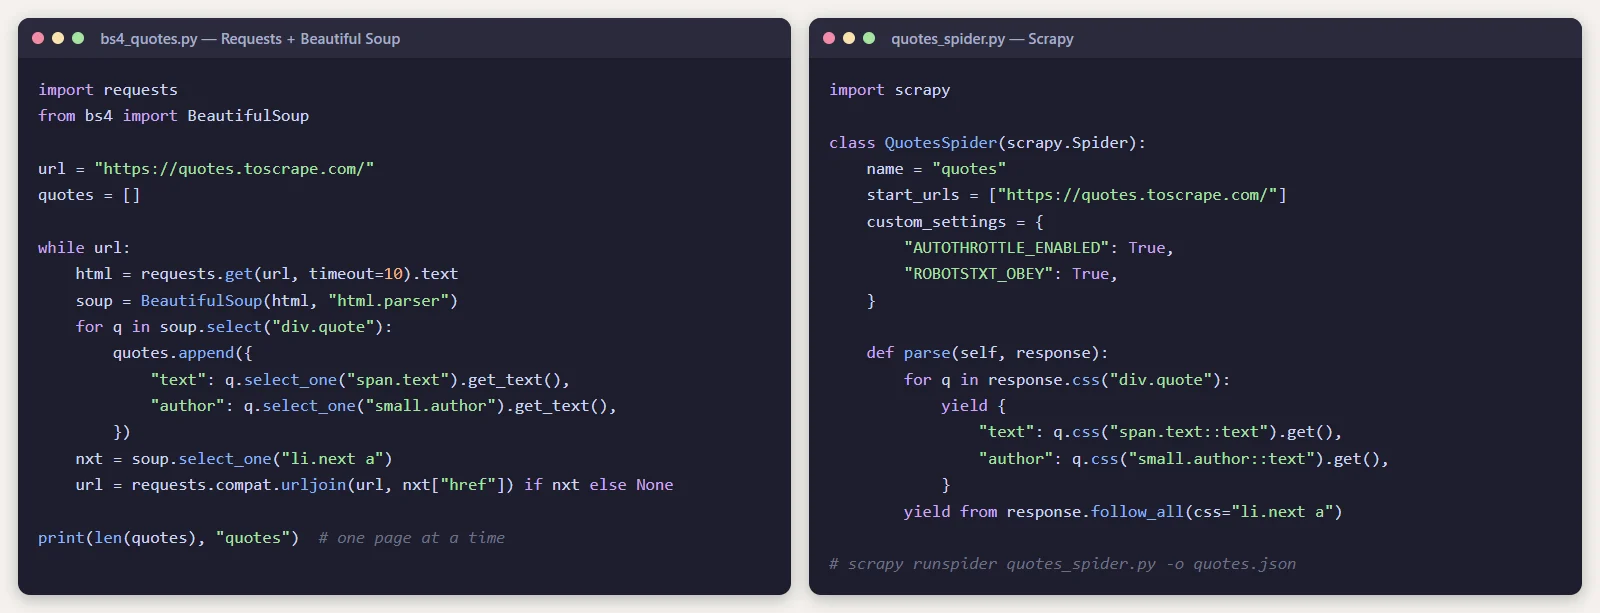
Ambos producen los mismos datos. La diferencia aparece cuando el trabajo crece: el script con BeautifulSoup espera a cada página antes de pedir la siguiente, mientras que Scrapy descarga muchas páginas en paralelo y se encarga por ti de los reintentos, la limitación de velocidad y la exportación.
Para probarlos tú mismo:
pip install requests beautifulsoup4
python bs4_quotes.py

pip install scrapy
scrapy runspider quotes_spider.py -o quotes.json
Comparativa lado a lado
| BeautifulSoup | Scrapy | |
|---|---|---|
| Tipo | Biblioteca de análisis HTML | Framework completo de rastreo |
| Curva de aprendizaje | Muy suave | Media |
| Descarga páginas | No, necesita Requests o httpx | Sí, integrado |
| Velocidad con muchas páginas | Lenta si no añades concurrencia tú mismo | Rápida, asíncrona por defecto |
| Seguir enlaces | Manual | Integrado |
| Exportación de datos | Manual | JSON, CSV y XML integrados |
| Limitación de velocidad y reintentos | Manual | Integrados |
| Páginas generadas con JavaScript | No | No, necesita un complemento |
| Ideal para | Scripts pequeños y trabajos puntuales | Rastreos grandes o recurrentes |
Cuándo elegir BeautifulSoup
- Necesitas datos de unas pocas páginas o vas a hacer scraping una sola vez.
- Estás aprendiendo web scraping o Python.
- Ya tienes el HTML, por ejemplo de una respuesta de API, un correo o un archivo guardado, y solo necesitas analizarlo.
- Quieres añadir un pequeño paso de scraping dentro de un script o aplicación existente.
Cuándo elegir Scrapy
- Necesitas rastrear cientos o miles de páginas.
- El scraper se ejecutará con regularidad y debe ser fiable.
- Necesitas seguir la paginación y los enlaces por todo un sitio.
- Los datos deben limpiarse, validarse y guardarse de forma estructurada.
- Quieres controles de cortesía integrados para no sobrecargar el sitio de destino.
¿Y los sitios web con mucho JavaScript?
Ni BeautifulSoup ni Scrapy ejecutan JavaScript. Si el contenido que necesitas se carga con JavaScript después de abrir la página, tienes dos opciones:
- Busca en las herramientas para desarrolladores del navegador la petición a la API que hace la página. Llamar directamente a ese endpoint JSON suele ser más rápido y estable que hacer scraping del HTML.
- Usa un navegador sin interfaz como Playwright o Selenium. Playwright se puede combinar con Scrapy mediante el plugin
scrapy-playwright, o usarse por separado con BeautifulSoup para el análisis.
¿Se pueden usar los dos juntos?
Sí. Scrapy tiene sus propios selectores rápidos, pero nada te impide pasar una respuesta a BeautifulSoup dentro de un callback de Scrapy si prefieres su API. Muchos equipos hacen el prototipo con Requests y BeautifulSoup y pasan a Scrapy cuando el trabajo necesita escalar.
Haz scraping de forma responsable
Que puedas hacer scraping de un sitio web no significa que tengas permiso. Antes de empezar:
- Lee los términos del servicio del sitio y respeta su archivo robots.txt.
- Limita la frecuencia de tus peticiones para no ralentizar nunca el sitio a sus visitantes reales.
- No recopiles datos personales sin una base legal. Leyes como el RGPD también se aplican a los datos obtenidos mediante scraping.
- Prioriza una API oficial cuando exista.
El veredicto
Para aprender, proyectos pequeños y extracciones rápidas de datos, BeautifulSoup es el mejor punto de partida: sencillo, tolerante y fácil de leer. Para cualquier cosa grande, recurrente o crítica para el negocio, Scrapy es la mejor herramienta, porque te da velocidad, estructura y controles de cortesía que de otro modo tendrías que construir tú mismo.
Si los datos obtenidos tienen que acabar en tus propios paneles, CRM o ERP, el scraper es solo una parte del sistema. En ArtinTech Solution desarrollamos sistemas internos a medida y aplicaciones web que recopilan, validan y utilizan datos como estos. Cuéntanos tu proyecto.
Preguntas frecuentes
¿Scrapy es más rápido que BeautifulSoup?
Para rastrear muchas páginas, sí, porque Scrapy envía peticiones de forma concurrente mientras que un script básico con Requests y BeautifulSoup descarga una página cada vez. Para analizar un único documento, la diferencia es pequeña.
¿BeautifulSoup es bueno para principiantes?
Sí. Es una de las formas más fáciles de aprender cómo se estructura el HTML y cómo extraer datos de él con Python.
¿Scrapy puede hacer scraping de webs con JavaScript?
No por sí solo. Usa la API subyacente del sitio si es posible, o añade un navegador sin interfaz con el plugin scrapy-playwright.
¿El web scraping es legal?
Depende de los términos del sitio web, del tipo de datos y de las leyes de tu país. Hacer scraping de datos públicos y no personales con moderación suele tener menos riesgo, pero revisa siempre los términos y busca asesoramiento legal para proyectos comerciales.