🌐 اقرأ هذا المقال بلغة أخرى: English · Español · Deutsch · Français · Bahasa Melayu · العربية · 简体中文 · 日本語
استخراج بيانات الويب (Web Scraping) هو جمع البيانات من المواقع تلقائياً، لأغراض البحث أو مراقبة الأسعار أو قوائم العملاء المحتملين أو تحليل السوق أو تغذية الأنظمة الداخلية. وفي Python تتصدر أداتان هذا المجال: BeautifulSoup وScrapy.
كثيراً ما تتم المقارنة بينهما كأنهما متنافستان، لكنهما تحلان مشكلتين مختلفتين. BeautifulSoup مكتبة لتحليل HTML، أما Scrapy فإطار عمل متكامل للزحف إلى المواقع على نطاق واسع. يشرح هذا الدليل الفرق بشيفرة حقيقية ويساعدك على اختيار الأداة المناسبة لمشروعك.
ما هي BeautifulSoup؟
تقرأ BeautifulSoup (الحزمة bs4) مستند HTML أو XML وتحوله إلى شجرة يمكنك البحث فيها بدوال Python بسيطة مثل find() وfind_all() ومحددات CSS عبر select(). لا تنزّل الصفحات بنفسها، لذا تُستخدم دائماً تقريباً مع مكتبة HTTP مثل Requests.
- سهلة التعلم جداً حتى للمبتدئين في Python.
- تتسامح مع HTML الفوضوي وغير السليم.
- تعمل مع محللات مختلفة:
html.parserالمدمج، وlxmlالسريع، وhtml5libلتحليل مشابه للمتصفح. - مثالية للنصوص البرمجية الصغيرة والمهام لمرة واحدة.
ما هو Scrapy؟
Scrapy إطار عمل مفتوح المصدر لبناء زواحف الويب التي تسمى spiders. يتولى سير العمل بالكامل: إرسال الطلبات، وتتبع الروابط، وتحليل الاستجابات، وتنظيف البيانات وتصديرها.
- غير متزامن بطبيعته. يرسل Scrapy طلبات كثيرة في الوقت نفسه، ما يجعله أسرع بكثير في المواقع الكبيرة.
- لباقة مدمجة. احترام robots.txt وAutoThrottle وتأخير التنزيل وإعادة المحاولة كلها إعدادات بسيطة.
- Item pipelines تنظف البيانات وتتحقق منها وتحفظها في قاعدة بيانات أو ملف.
- Feed exports تكتب JSON أو CSV أو XML بأمر واحد.
- Middlewares تتيح لك تخصيص الترويسات والوكلاء والتخزين المؤقت ومعالجة الأخطاء.
أداة الاستخراج نفسها بالأداتين
يجمع المثال التالي كل الاقتباسات ومؤلفيها من quotes.toscrape.com، وهو موقع مخصص للتدرب على الاستخراج. على اليسار Requests مع BeautifulSoup، وعلى اليمين spider من Scrapy.
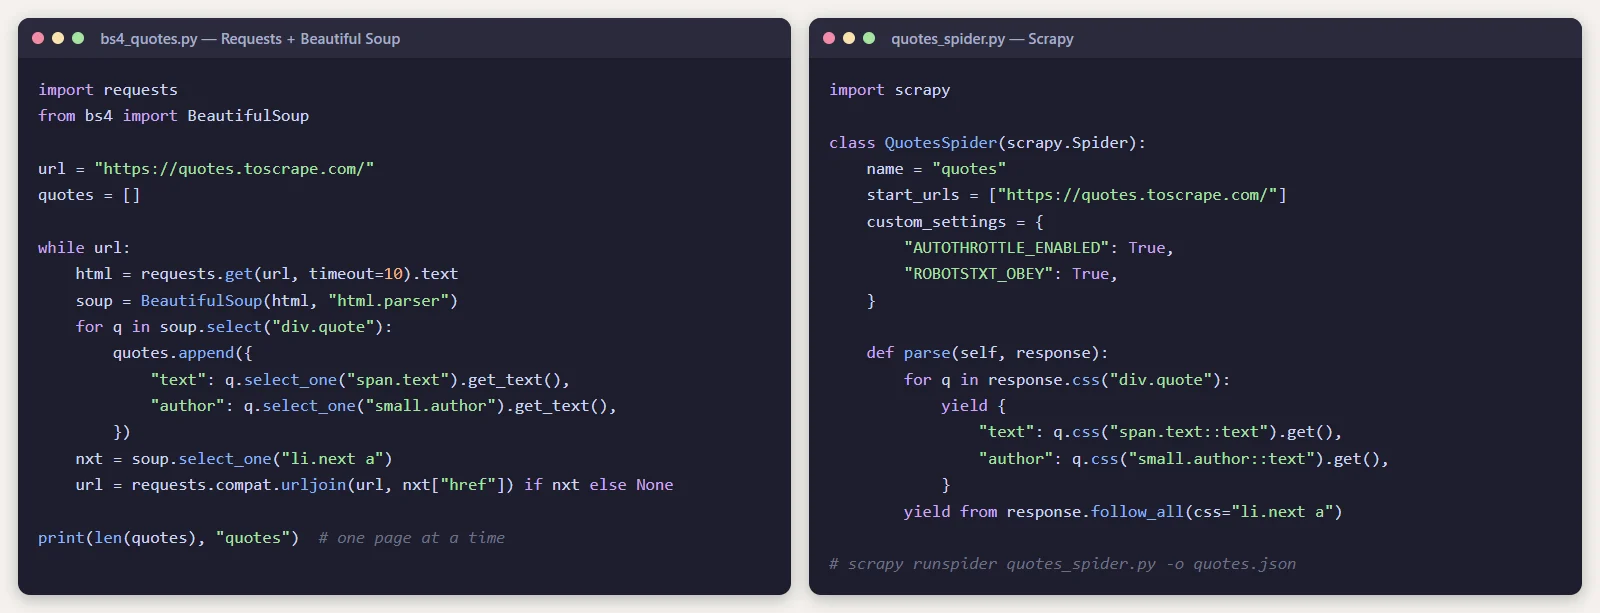
كلاهما ينتج البيانات نفسها. يظهر الفرق عندما تكبر المهمة: ينتظر نص BeautifulSoup كل صفحة قبل طلب التالية، بينما ينزّل Scrapy صفحات كثيرة بالتوازي ويتولى عنك إعادة المحاولة والتحكم في السرعة والتصدير.
لتجربتهما بنفسك:
pip install requests beautifulsoup4
python bs4_quotes.py

pip install scrapy
scrapy runspider quotes_spider.py -o quotes.json
مقارنة جنباً إلى جنب
| BeautifulSoup | Scrapy | |
|---|---|---|
| النوع | مكتبة لتحليل HTML | إطار زحف متكامل |
| منحنى التعلم | سهل جداً | متوسط |
| تنزيل الصفحات | لا، تحتاج إلى Requests أو httpx | نعم، مدمج |
| السرعة مع صفحات كثيرة | بطيئة ما لم تضف التزامن بنفسك | سريع وغير متزامن افتراضياً |
| تتبع الروابط | يدوي | مدمج |
| تصدير البيانات | يدوي | JSON وCSV وXML مدمجة |
| التحكم في السرعة وإعادة المحاولة | يدوي | مدمج |
| الصفحات المولّدة بـ JavaScript | لا | لا، يحتاج إلى إضافة |
| الأنسب لـ | النصوص الصغيرة والمهام لمرة واحدة | الزحف الكبير أو المتكرر |
متى تختار BeautifulSoup
- تحتاج إلى بيانات من صفحات قليلة، أو ستستخرجها مرة واحدة فقط.
- تتعلم استخراج بيانات الويب أو Python.
- لديك HTML بالفعل، مثلاً من استجابة API أو بريد إلكتروني أو ملف محفوظ، وتحتاج فقط إلى تحليله.
- تريد إضافة خطوة استخراج صغيرة داخل نص برمجي أو تطبيق قائم.
متى تختار Scrapy
- تحتاج إلى الزحف إلى مئات أو آلاف الصفحات.
- ستعمل أداة الاستخراج بانتظام ويجب أن تكون موثوقة.
- تحتاج إلى تتبع ترقيم الصفحات والروابط عبر موقع كامل.
- يجب تنظيف البيانات والتحقق منها وتخزينها بشكل منظم.
- تريد ضوابط لباقة مدمجة حتى لا تُثقل على الموقع المستهدف.
ماذا عن المواقع المعتمدة على JavaScript؟
لا تشغّل BeautifulSoup ولا Scrapy شيفرة JavaScript. إذا كان المحتوى الذي تحتاجه يُحمَّل بواسطة JavaScript بعد فتح الصفحة، فلديك خياران:
- ابحث في أدوات المطور في متصفحك عن طلب API الذي ترسله الصفحة. استدعاء نقطة JSON هذه مباشرة يكون عادةً أسرع وأكثر ثباتاً من استخراج HTML.
- استخدم متصفحاً بلا واجهة مثل Playwright أو Selenium. يمكن دمج Playwright مع Scrapy عبر الإضافة
scrapy-playwright، أو استخدامه بمفرده مع BeautifulSoup للتحليل.
هل يمكن استخدامهما معاً؟
نعم. لدى Scrapy محدداته السريعة الخاصة، لكن لا شيء يمنعك من تمرير الاستجابة إلى BeautifulSoup داخل دالة callback في Scrapy إذا كنت تفضل واجهتها. تبني فرق كثيرة النموذج الأولي بـ Requests وBeautifulSoup، ثم تنتقل إلى Scrapy عندما تحتاج المهمة إلى التوسع.
استخرج البيانات بمسؤولية
قدرتك على استخراج بيانات موقع لا تعني أنه مسموح لك بذلك. قبل أن تبدأ:
- اقرأ شروط استخدام الموقع واحترم ملف robots.txt الخاص به.
- حدّ من معدل طلباتك حتى لا تبطئ الموقع على زواره الحقيقيين.
- لا تجمع بيانات شخصية دون أساس قانوني. فقوانين مثل GDPR تنطبق على البيانات المستخرجة أيضاً.
- فضّل واجهة API رسمية عندما تتوفر.
الخلاصة
للتعلم والمشاريع الصغيرة والاستخراج السريع للبيانات، تعد BeautifulSoup أفضل نقطة بداية: بسيطة ومتسامحة وسهلة القراءة. أما لأي عمل كبير أو متكرر أو حيوي للأعمال، فإن Scrapy هو الأداة الأفضل، لأنه يمنحك السرعة والبنية وضوابط اللباقة التي كنت ستضطر إلى بنائها بنفسك.
إذا كانت البيانات المستخرجة ستنتهي في لوحات التحكم أو نظام CRM أو ERP الخاص بك، فإن أداة الاستخراج مجرد جزء من النظام. في ArtinTech Solution نبني أنظمة داخلية مخصصة وتطبيقات ويب تجمع مثل هذه البيانات وتتحقق منها وتستخدمها. أخبرنا عن مشروعك.
الأسئلة الشائعة
هل Scrapy أسرع من BeautifulSoup؟
عند الزحف إلى صفحات كثيرة نعم، لأن Scrapy يرسل الطلبات بشكل متزامن بينما يجلب نص Requests وBeautifulSoup البسيط صفحة واحدة في كل مرة. أما عند تحليل مستند واحد فالفرق صغير.
هل BeautifulSoup مناسبة للمبتدئين؟
نعم. إنها من أسهل الطرق لتعلم بنية HTML وكيفية استخراج البيانات منه باستخدام Python.
هل يستطيع Scrapy استخراج بيانات مواقع JavaScript؟
ليس بمفرده. استخدم واجهة API الخاصة بالموقع إن أمكن، أو أضف متصفحاً بلا واجهة عبر إضافة scrapy-playwright.
هل استخراج بيانات الويب قانوني؟
يعتمد ذلك على شروط الموقع ونوع البيانات والقوانين في بلدك. استخراج البيانات العامة غير الشخصية باعتدال أقل خطورة عادةً، لكن راجع الشروط دائماً واطلب استشارة قانونية للمشاريع التجارية.