🌐 Læs denne artikel på et andet sprog: English · Dansk · Español · Deutsch · Français · Bahasa Melayu · العربية · 简体中文 · 日本語
Web scraping er automatisk udtrækning af data fra hjemmesider til research, prisovervågning, leadlister, markedsanalyse eller til at fodre interne systemer med data. I Python dominerer to værktøjer samtalen: BeautifulSoup og Scrapy.
De bliver ofte sammenlignet, som om de var konkurrenter, men de løser forskellige problemer. BeautifulSoup er et bibliotek til at parse HTML. Scrapy er et komplet framework til at crawle hjemmesider i stor skala. Denne guide forklarer forskellen med rigtig kode og hjælper dig med at vælge det rigtige værktøj til dit projekt.
Hvad er BeautifulSoup?
BeautifulSoup (pakken bs4 ) læser et HTML- eller XML-dokument og gør det til et træ, du kan søge i med enkle Python-metoder som find(), find_all() og CSS-selektorer via select(). Det henter ikke selv sider, så det kombineres næsten altid med et HTTP-bibliotek som Requests.
- Meget nemt at lære, også for begyndere i Python.
- Tolerant over for rodet, forkert formateret HTML.
- Virker med forskellige parsere: den indbyggede
html.parser, den hurtigelxmlellerhtml5libtil parsing som i en browser. - Ideelt til små scripts og engangsopgaver.
Hvad er Scrapy?
Scrapy er et open source-framework til at bygge webcrawlere, kaldet spiders. Det håndterer hele flowet: at sende forespørgsler, følge links, parse svar, rense data og eksportere dem.
- Asynkront fra starten. Scrapy sender mange forespørgsler samtidig, hvilket gør det langt hurtigere på store sites.
- Indbygget høflighed. At overholde robots.txt, AutoThrottle, forsinkelser på downloads og genforsøg er simple indstillinger.
- Item pipelines renser, validerer og gemmer data i en database eller fil.
- Feed exports skriver JSON, CSV eller XML med en enkelt kommando.
- Middlewares lader dig tilpasse headere, proxyer, caching og fejlhåndtering.
Den samme scraper i begge værktøjer
Eksemplet nedenfor indsamler alle citater og forfattere fra quotes.toscrape.com, en side bygget til at øve scraping. Til venstre er Requests med BeautifulSoup, til højre en Scrapy-spider.
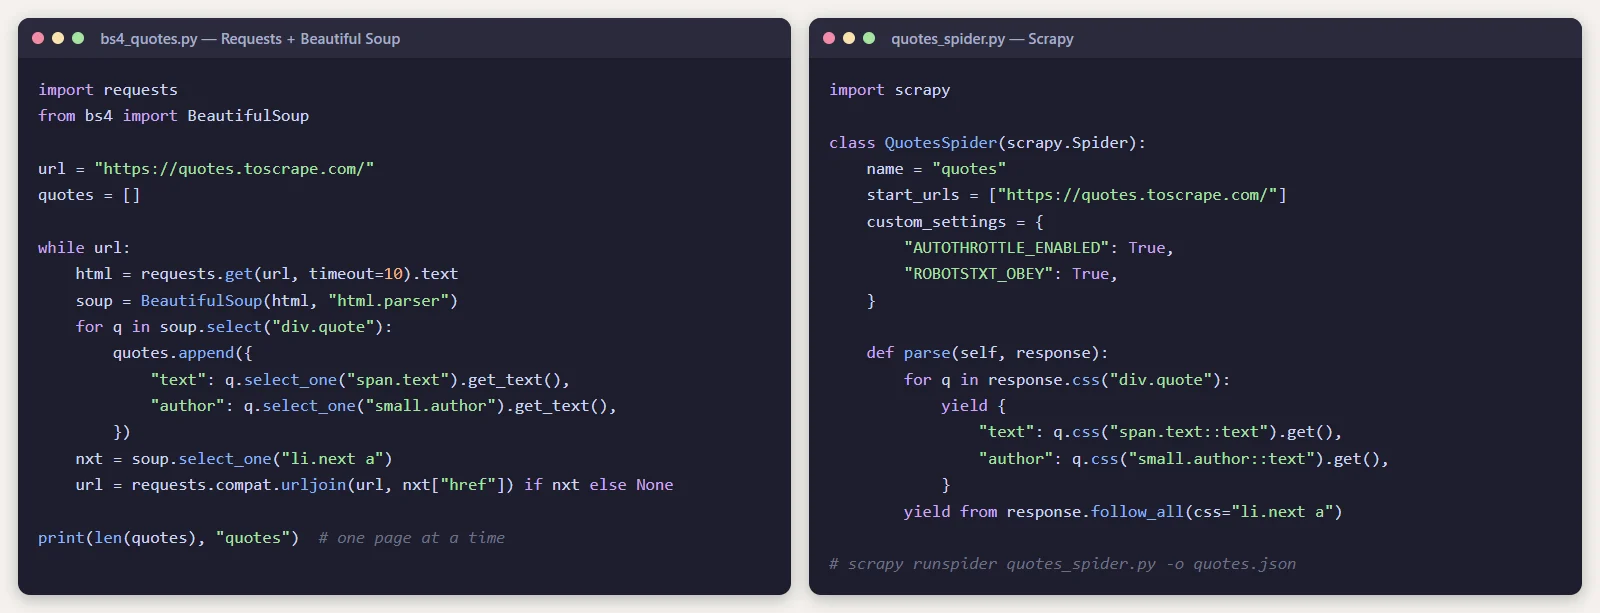
Begge giver de samme data. Forskellen viser sig, når opgaven vokser: BeautifulSoup-scriptet venter på hver side, før det henter den næste, mens Scrapy henter mange sider parallelt og håndterer genforsøg, begrænsning og eksport for dig.
Sådan prøver du dem selv:
pip install requests beautifulsoup4
python bs4_quotes.py

pip install scrapy
scrapy runspider quotes_spider.py -o quotes.json
Sammenligning side om side
| BeautifulSoup | Scrapy | |
|---|---|---|
| Type | Bibliotek til HTML-parsing | Komplet crawling-framework |
| Læringskurve | Meget blød | Moderat |
| Henter sider | Nej, kræver Requests eller httpx | Ja, indbygget |
| Hastighed på mange sider | Langsom, medmindre du selv tilføjer samtidighed | Hurtig, asynkron som standard |
| Følger links | Manuelt | Indbygget |
| Dataeksport | Manuelt | JSON, CSV og XML indbygget |
| Begrænsning og genforsøg | Manuelt | Indbygget |
| Sider vist med JavaScript | Nej | Nej, kræver en udvidelse |
| Bedst til | Små scripts og engangsopgaver | Store eller tilbagevendende crawls |
Hvornår du skal vælge BeautifulSoup
- Du skal bruge data fra få sider, eller du scraper én gang.
- Du er ved at lære web scraping eller Python.
- Du har allerede HTML’en, for eksempel fra et API-svar, en mail eller en gemt fil, og skal bare parse den.
- Du vil tilføje et lille scraping-trin i et eksisterende script eller en applikation.
Hvornår du skal vælge Scrapy
- Du skal crawle hundredvis eller tusindvis af sider.
- Scraperen skal køre jævnligt og være pålidelig.
- Du skal følge sidenummerering og links på tværs af et helt site.
- Data skal renses, valideres og gemmes struktureret.
- Du vil have indbyggede høflighedskontroller, så du ikke overbelaster målsiden.
Hvad med sider med meget JavaScript?
Hverken BeautifulSoup eller Scrapy kører JavaScript. Hvis det indhold, du skal bruge, indlæses af JavaScript, efter siden er åbnet, har du to muligheder:
- Find den API-forespørgsel, siden laver, i browserens udviklerværktøjer. At kalde det JSON-endpoint direkte er som regel hurtigere og mere stabilt end at scrape HTML.
- Brug en headless browser som Playwright eller Selenium. Playwright kan kombineres med Scrapy via
scrapy-playwright-pluginet eller bruges alene med BeautifulSoup til parsing.
Kan du bruge begge sammen?
Ja. Scrapy har sine egne hurtige selektorer, men intet forhindrer dig i at give et svar videre til BeautifulSoup i en Scrapy-callback, hvis du foretrækker dets API. Mange teams laver en prototype med Requests og BeautifulSoup og skifter til Scrapy, når opgaven skal skaleres.
Scrap ansvarligt
At du kan scrape en hjemmeside, betyder ikke, at du må. Før du går i gang:
- Læs hjemmesidens vilkår, og respektér dens robots.txt-fil.
- Begræns antallet af forespørgsler, så du aldrig gør siden langsommere for rigtige besøgende.
- Indsaml ikke personoplysninger uden et lovligt grundlag. Love som GDPR gælder også for scrapede data.
- Foretræk et officielt API, når der findes et.
Konklusionen
Til læring, små projekter og hurtig udtrækning af data er BeautifulSoup det bedste udgangspunkt: enkelt, tilgivende og nemt at læse. Til alt, der er stort, tilbagevendende eller forretningskritisk, er Scrapy det bedste værktøj, fordi det giver dig hastighed, struktur og høflighedskontroller, som du ellers selv skulle bygge.
Hvis scrapede data skal ende i dine egne dashboards, dit CRM eller ERP, er scraperen kun én del af systemet. Hos ArtinTech Solution bygger vi skræddersyede interne systemer og webapplikationer , der indsamler, validerer og bruger data som disse. Fortæl os om dit projekt.
Ofte stillede spørgsmål
Er Scrapy hurtigere end BeautifulSoup?
Til at crawle mange sider, ja, fordi Scrapy sender forespørgsler samtidig, mens et simpelt script med Requests og BeautifulSoup henter én side ad gangen. Til at parse et enkelt dokument er forskellen lille.
Er BeautifulSoup godt for begyndere?
Ja. Det er en af de nemmeste måder at lære, hvordan HTML er struktureret, og hvordan man udtrækker data fra det med Python.
Kan Scrapy scrape JavaScript-sider?
Ikke alene. Brug sidens underliggende API, hvis det er muligt, eller tilføj en headless browser via pluginet scrapy-playwright.
Er web scraping lovligt?
Det afhænger af sidens vilkår, typen af data og lovgivningen i dit land. At scrape offentlige, ikke-personlige data høfligt er generelt forbundet med lavere risiko, men tjek altid vilkårene, og få juridisk rådgivning til kommercielle projekter.