🌐 他の言語で読む: English · Español · Deutsch · Français · Bahasa Melayu · العربية · 简体中文 · 日本語
Web スクレイピングとは、Web サイトからデータを自動的に抽出することです。調査、価格モニタリング、見込み客リスト、市場分析、社内システムへのデータ供給などに使われます。Python では、BeautifulSoup と Scrapy の2つのツールが代表的です。
両者はよく競合のように比較されますが、解決する課題は異なります。BeautifulSoup は HTML を解析するためのライブラリ、Scrapy は大規模なサイトをクロールするための本格的なフレームワークです。このガイドでは、実際のコードで違いを説明し、プロジェクトに合ったツール選びをお手伝いします。
BeautifulSoup とは?
BeautifulSoup(bs4 パッケージ)は HTML や XML の文書を読み込み、find()、find_all()、select() による CSS セレクターなど、シンプルな Python のメソッドで検索できるツリーに変換します。ページのダウンロード機能は持たないため、ほぼ必ず Requests などの HTTP ライブラリと組み合わせて使います。
- Python 初心者でも非常に習得しやすい。
- 乱れた HTML や不正な HTML にも寛容。
- 標準の
html.parser、高速なlxml、ブラウザーに近い解析を行うhtml5libなど、複数のパーサーに対応。 - 小さなスクリプトや単発の作業に最適。
Scrapy とは?
Scrapy は、spider と呼ばれる Web クローラーを構築するためのオープンソースフレームワークです。リクエストの送信、リンクの追跡、レスポンスの解析、データのクレンジングとエクスポートまで、一連の処理をすべて担います。
- 設計段階から非同期。 多数のリクエストを同時に送信するため、大規模サイトでははるかに高速です。
- マナーを守る仕組みが標準装備。 robots.txt の遵守、AutoThrottle、ダウンロード間隔、リトライは簡単な設定だけで有効にできます。
- Item pipelines がデータのクレンジング、検証、データベースやファイルへの保存を行います。
- Feed exports により、コマンド1つで JSON、CSV、XML を出力できます。
- Middlewares でヘッダー、プロキシ、キャッシュ、エラー処理をカスタマイズできます。
同じスクレイパーを両方のツールで
以下の例は、スクレイピング練習用に作られたサイト quotes.toscrape.com から、すべての名言と著者を収集します。左が Requests+BeautifulSoup、右が Scrapy の spider です。
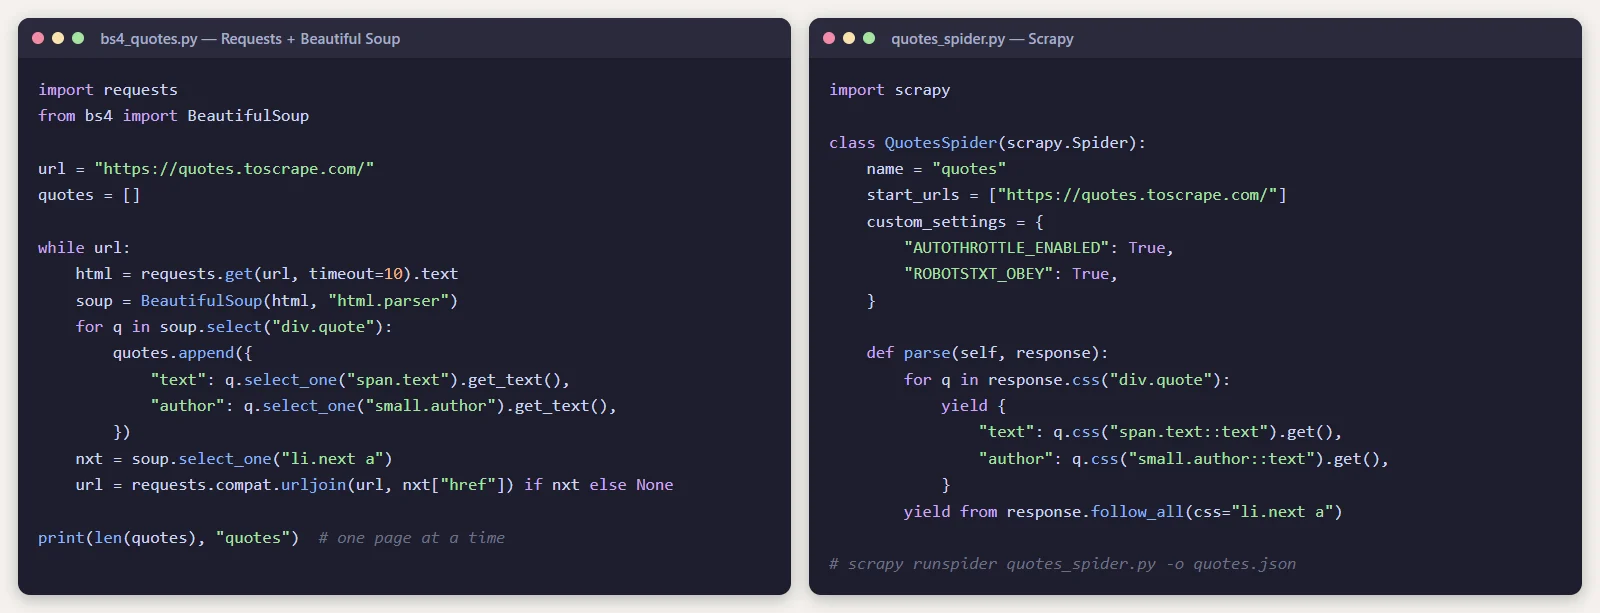
どちらも同じデータを取得します。違いが表れるのは作業量が増えたときです。BeautifulSoup のスクリプトは1ページの取得を待ってから次を要求しますが、Scrapy は多数のページを並列でダウンロードし、リトライ、速度制御、エクスポートも自動で処理します。
自分で試すには:
pip install requests beautifulsoup4
python bs4_quotes.py

pip install scrapy
scrapy runspider quotes_spider.py -o quotes.json
一覧で比較
| BeautifulSoup | Scrapy | |
|---|---|---|
| 種類 | HTML 解析ライブラリ | 本格的なクロールフレームワーク |
| 学習コスト | 非常に低い | 中程度 |
| ページのダウンロード | 不可(Requests や httpx が必要) | 可能(標準搭載) |
| 大量ページでの速度 | 自分で並行処理を実装しない限り遅い | 高速(標準で非同期) |
| リンクの追跡 | 手動 | 標準搭載 |
| データのエクスポート | 手動 | JSON・CSV・XML を標準搭載 |
| 速度制御とリトライ | 手動 | 標準搭載 |
| JavaScript で描画されるページ | 非対応 | 非対応(拡張機能が必要) |
| 最適な用途 | 小さなスクリプトや単発作業 | 大規模・定期的なクロール |
BeautifulSoup を選ぶべきケース
- 数ページ分のデータだけが必要、または一度きりの作業である。
- Web スクレイピングや Python を学習中である。
- API のレスポンス、メール、保存済みファイルなどから HTML がすでに手元にあり、解析するだけでよい。
- 既存のスクリプトやアプリケーションに小さなスクレイピング処理を追加したい。
Scrapy を選ぶべきケース
- 数百〜数千ページをクロールする必要がある。
- スクレイパーを定期的に実行し、安定性が求められる。
- サイト全体でページ送りやリンクをたどる必要がある。
- データをクレンジング・検証し、構造化して保存する必要がある。
- 対象サイトに負荷をかけないよう、マナーを守る仕組みを標準で使いたい。
JavaScript を多用するサイトはどうする?
BeautifulSoup も Scrapy も JavaScript は実行しません。必要なコンテンツがページ表示後に JavaScript で読み込まれる場合は、次の2つの方法があります。
- ブラウザーの開発者ツールで、そのページが送信している API リクエストを探します。その JSON エンドポイントを直接呼び出すほうが、HTML をスクレイピングするより通常は高速で安定しています。
- Playwright や Selenium などのヘッドレスブラウザーを使います。Playwright は
scrapy-playwrightプラグインで Scrapy と組み合わせることも、単独で使って BeautifulSoup で解析することもできます。
両方を組み合わせて使える?
使えます。Scrapy には独自の高速なセレクターがありますが、BeautifulSoup の API が好みなら、Scrapy のコールバック内でレスポンスを BeautifulSoup に渡しても問題ありません。多くのチームは Requests と BeautifulSoup でプロトタイプを作り、規模の拡大が必要になった段階で Scrapy に移行しています。
責任あるスクレイピングを
技術的にスクレイピングできることと、許可されていることは別です。始める前に:
- サイトの利用規約を読み、robots.txt を尊重しましょう。
- 実際の訪問者にとってサイトが遅くならないよう、リクエスト頻度を制限しましょう。
- 法的根拠なしに個人データを収集しないでください。GDPR や日本の個人情報保護法などの法律は、スクレイピングで取得したデータにも適用されます。
- 公式 API がある場合は、そちらを優先しましょう。
結論
学習、小規模なプロジェクト、手早いデータ抽出には、シンプルで寛容、読みやすい BeautifulSoup が最適な出発点です。大規模、定期的、あるいはビジネス上重要な作業には、Scrapy のほうが優れています。自分で作らなければならない速度、構造、マナーを守る仕組みがすべて揃っているからです。
スクレイピングしたデータを自社のダッシュボード、CRM、ERP で活用するなら、スクレイパーはシステムの一部にすぎません。ArtinTech Solution では、こうしたデータを収集・検証・活用する カスタム社内システム や Web アプリケーション を開発しています。プロジェクトについてお聞かせください。
よくある質問
Scrapy は BeautifulSoup より速いですか?
多数のページをクロールする場合は速いです。Scrapy はリクエストを並行して送信しますが、基本的な Requests+BeautifulSoup のスクリプトは1ページずつ取得するためです。1つの文書を解析するだけなら、差はわずかです。
BeautifulSoup は初心者向けですか?
はい。HTML の構造と、Python でそこからデータを抽出する方法を学ぶうえで、最も簡単な方法の一つです。
Scrapy で JavaScript サイトをスクレイピングできますか?
Scrapy 単体ではできません。可能であればサイトの裏側にある API を使うか、scrapy-playwright プラグインでヘッドレスブラウザーを追加してください。
Web スクレイピングは合法ですか?
サイトの利用規約、データの種類、お住まいの国の法律によって異なります。公開されている個人情報以外のデータを節度を持って収集する場合は一般的にリスクが低いですが、必ず規約を確認し、商用プロジェクトでは法律の専門家に相談してください。