🌐 阅读其他语言版本: English · Español · Deutsch · Français · Bahasa Melayu · العربية · 简体中文 · 日本語
网页抓取(Web Scraping)是从网站自动提取数据的过程,可用于研究、价格监控、潜在客户名单、市场分析,或为内部系统提供数据。在 Python 中,有两个工具最受关注:BeautifulSoup 和 Scrapy。
人们常把它们当作竞争对手来比较,但它们解决的是不同的问题。BeautifulSoup 是用于解析 HTML 的库;Scrapy 是用于大规模爬取网站的完整框架。本指南通过真实代码解释两者的区别,帮助您为项目选择合适的工具。
什么是 BeautifulSoup?
BeautifulSoup(bs4 包)读取 HTML 或 XML 文档,并把它转换成一棵树,您可以用 find()、find_all() 以及通过 select() 使用 CSS 选择器等简单的 Python 方法进行查找。它本身不下载网页,所以几乎总是与 Requests 等 HTTP 库搭配使用。
- 非常容易学习,Python 初学者也能快速上手。
- 能容忍杂乱、不规范的 HTML。
- 支持多种解析器:内置的
html.parser、速度快的lxml,以及接近浏览器解析方式的html5lib。 - 适合小脚本和一次性任务。
什么是 Scrapy?
Scrapy 是一个开源框架,用于构建称为 spider 的网络爬虫。它负责完整的工作流程:发送请求、跟踪链接、解析响应、清洗数据并导出。
- 天生异步。 Scrapy 同时发送大量请求,因此在大型网站上速度快得多。
- 内置礼貌机制。 遵守 robots.txt、AutoThrottle、下载延迟和重试都只需简单配置。
- Item pipelines 负责清洗、校验数据,并将其保存到数据库或文件。
- Feed exports 只需一条命令即可输出 JSON、CSV 或 XML。
- Middlewares 可自定义请求头、代理、缓存和错误处理。
用两种工具实现同一个爬虫
下面的示例从 quotes.toscrape.com(一个专供练习抓取的网站)收集所有名言及作者。左边是 Requests + BeautifulSoup,右边是 Scrapy spider。
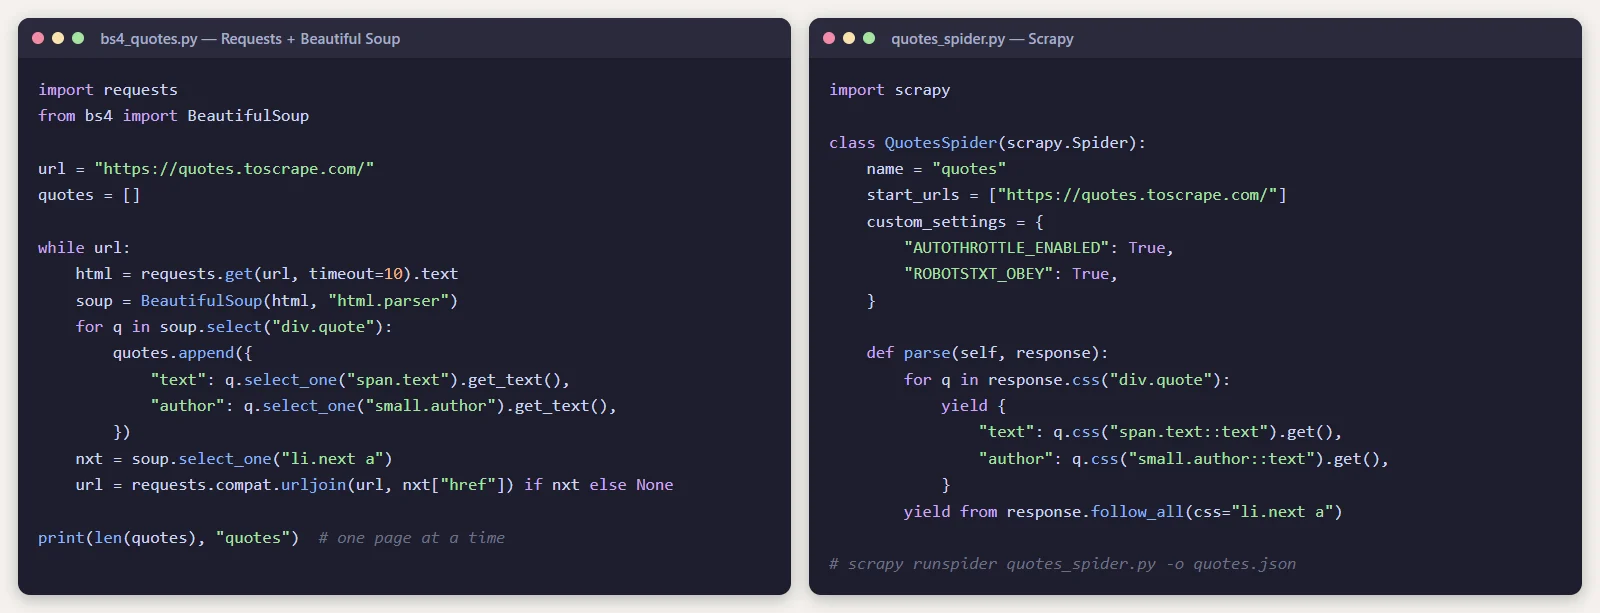
两者得到的数据相同。差异在任务规模变大时显现:BeautifulSoup 脚本要等一个页面下载完才请求下一个,而 Scrapy 会并行下载多个页面,并替您处理重试、限速和导出。
自己动手试试:
pip install requests beautifulsoup4
python bs4_quotes.py

pip install scrapy
scrapy runspider quotes_spider.py -o quotes.json
并列对比
| BeautifulSoup | Scrapy | |
|---|---|---|
| 类型 | HTML 解析库 | 完整的爬虫框架 |
| 学习曲线 | 非常平缓 | 中等 |
| 下载网页 | 不支持,需要 Requests 或 httpx | 支持,内置 |
| 大量页面时的速度 | 较慢,除非自行实现并发 | 快,默认异步 |
| 跟踪链接 | 手动 | 内置 |
| 数据导出 | 手动 | 内置 JSON、CSV 和 XML |
| 限速与重试 | 手动 | 内置 |
| JavaScript 渲染的页面 | 不支持 | 不支持,需要插件 |
| 最适合 | 小脚本和一次性任务 | 大规模或定期爬取 |
何时选择 BeautifulSoup
- 只需要几个页面的数据,或者只抓取一次。
- 正在学习网页抓取或 Python。
- 已经有 HTML(例如来自 API 响应、电子邮件或保存的文件),只需解析。
- 想在现有脚本或应用中加入一个小的抓取步骤。
何时选择 Scrapy
- 需要爬取成百上千个页面。
- 爬虫将定期运行,必须稳定可靠。
- 需要在整个网站中跟踪分页和链接。
- 数据必须经过清洗、校验并结构化存储。
- 希望有内置的礼貌机制,避免给目标网站造成过大负担。
JavaScript 较多的网站怎么办?
BeautifulSoup 和 Scrapy 都不执行 JavaScript。如果您需要的内容是在页面打开后由 JavaScript 加载的,有两种办法:
- 在浏览器开发者工具中找到页面发出的 API 请求。直接调用该 JSON 接口通常比抓取 HTML 更快、更稳定。
- 使用 Playwright 或 Selenium 等无头浏览器。Playwright 可以通过
scrapy-playwright插件与 Scrapy 结合,也可以单独使用,再交给 BeautifulSoup 解析。
两者可以一起使用吗?
可以。Scrapy 有自己的高速选择器,但如果您更喜欢 BeautifulSoup 的 API,也完全可以在 Scrapy 回调中把响应交给它处理。许多团队先用 Requests 和 BeautifulSoup 做原型,等任务需要扩展时再迁移到 Scrapy。
负责任地抓取
能够抓取一个网站,并不代表您被允许这样做。开始之前:
- 阅读网站的服务条款,并遵守其 robots.txt 文件。
- 限制请求频率,绝不让网站因此变慢、影响真实访客。
- 没有合法依据时不要收集个人数据。GDPR 等法律同样适用于抓取的数据。
- 如果有官方 API,优先使用官方 API。
结论
对于学习、小项目和快速提取数据,BeautifulSoup 是最好的起点:简单、容错、易读。对于大规模、定期运行或关键业务的任务,Scrapy 是更好的工具,因为它提供了速度、结构和礼貌机制,否则这些都得您自己实现。
如果抓取的数据需要进入您自己的仪表盘、CRM 或 ERP,爬虫只是整个系统的一部分。ArtinTech Solution 开发 定制内部系统 和 Web 应用,用于采集、校验和使用这类数据。告诉我们您的项目。
常见问题
Scrapy 比 BeautifulSoup 快吗?
在爬取大量页面时是的,因为 Scrapy 并发发送请求,而基础的 Requests + BeautifulSoup 脚本一次只获取一个页面。如果只是解析单个文档,差别不大。
BeautifulSoup 适合初学者吗?
适合。它是学习 HTML 结构以及如何用 Python 从中提取数据的最简单方式之一。
Scrapy 能抓取 JavaScript 网站吗?
单靠 Scrapy 不行。尽可能使用网站底层的 API,或通过 scrapy-playwright 插件加入无头浏览器。
网页抓取合法吗?
这取决于网站条款、数据类型以及您所在国家的法律。适度抓取公开的非个人数据通常风险较低,但务必查看条款,商业项目请咨询法律意见。