🌐 Baca artikel ini dalam bahasa lain: English · Español · Deutsch · Français · Bahasa Melayu · العربية · 简体中文 · 日本語
Web scraping ialah proses mengekstrak data daripada laman web secara automatik, untuk penyelidikan, pemantauan harga, senarai prospek, analisis pasaran atau menyalurkan data ke sistem dalaman. Dalam Python, dua alat mendominasi perbincangan: BeautifulSoup dan Scrapy.
Kedua-duanya sering dibandingkan seolah-olah pesaing, tetapi sebenarnya menyelesaikan masalah berbeza. BeautifulSoup ialah pustaka untuk menghurai HTML. Scrapy ialah rangka kerja lengkap untuk merangkak laman web secara besar-besaran. Panduan ini menerangkan perbezaannya dengan kod sebenar dan membantu anda memilih alat yang sesuai.
Apa itu BeautifulSoup?
BeautifulSoup (pakej bs4) membaca dokumen HTML atau XML dan menukarnya menjadi pepohon yang boleh dicari dengan kaedah Python ringkas seperti find(), find_all() dan pemilih CSS melalui select(). Ia tidak memuat turun halaman sendiri, jadi hampir selalu digandingkan dengan pustaka HTTP seperti Requests.
- Sangat mudah dipelajari, walaupun untuk pemula Python.
- Bertoleransi terhadap HTML yang bersepah dan tidak sempurna.
- Berfungsi dengan penghurai berbeza:
html.parserterbina dalam,lxmlyang pantas, atauhtml5libuntuk penghuraian seperti pelayar. - Sesuai untuk skrip kecil dan tugasan sekali sahaja.
Apa itu Scrapy?
Scrapy ialah rangka kerja sumber terbuka untuk membina perangkak web, yang dipanggil spider. Ia mengendalikan keseluruhan aliran kerja: menghantar permintaan, mengikut pautan, menghurai respons, membersihkan data dan mengeksportnya.
- Tak segerak secara reka bentuk. Scrapy menghantar banyak permintaan serentak, menjadikannya jauh lebih pantas pada laman besar.
- Adab terbina dalam. Mematuhi robots.txt, AutoThrottle, kelewatan muat turun dan cubaan semula hanyalah tetapan mudah.
- Item pipelines membersihkan, mengesahkan dan menyimpan data dalam pangkalan data atau fail.
- Feed exports menulis JSON, CSV atau XML dengan satu arahan.
- Middlewares membolehkan anda menyesuaikan pengepala, proksi, cache dan pengendalian ralat.
Scraper yang sama dengan kedua-dua alat
Contoh di bawah mengumpul setiap petikan dan pengarang daripada quotes.toscrape.com, laman yang dibina untuk berlatih scraping. Di kiri ialah Requests dengan BeautifulSoup, di kanan spider Scrapy.
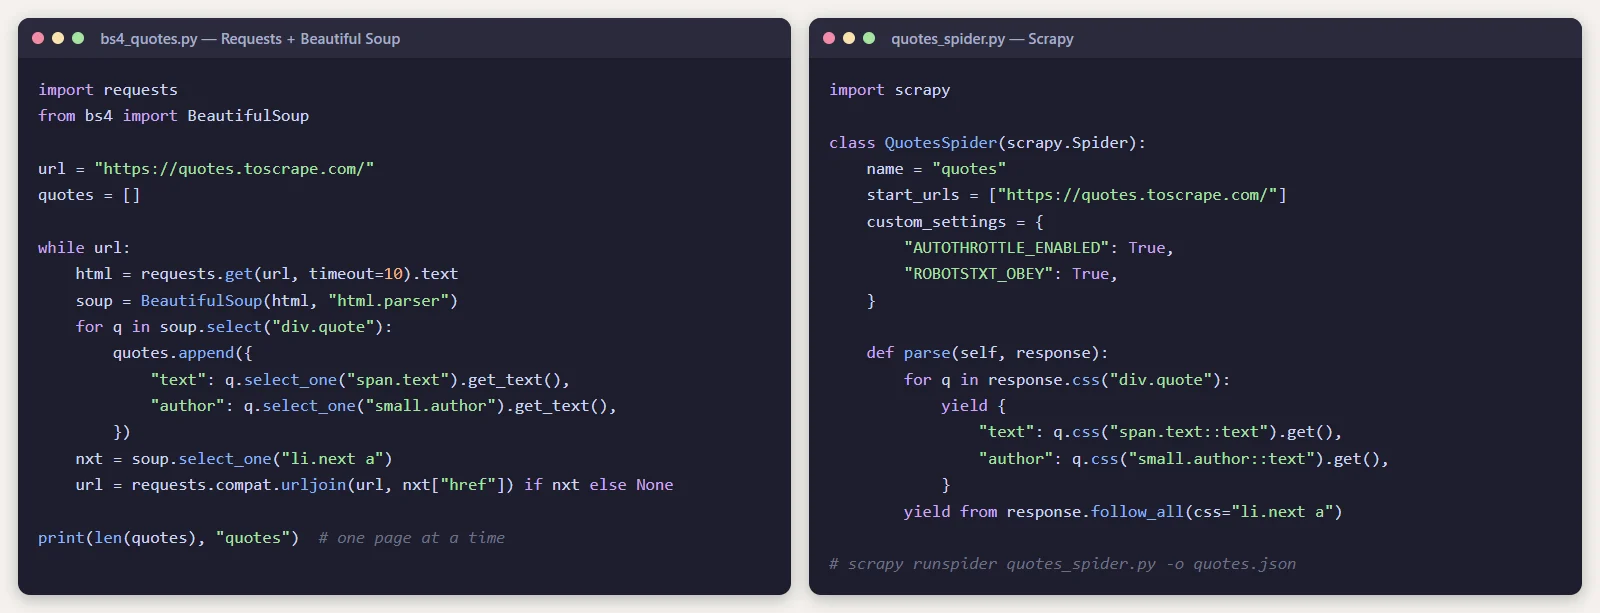
Kedua-duanya menghasilkan data yang sama. Perbezaan jelas apabila tugas membesar: skrip BeautifulSoup menunggu setiap halaman sebelum meminta yang seterusnya, manakala Scrapy memuat turun banyak halaman secara selari dan menguruskan cubaan semula, pendikitan dan eksport untuk anda.
Untuk mencubanya sendiri:
pip install requests beautifulsoup4
python bs4_quotes.py

pip install scrapy
scrapy runspider quotes_spider.py -o quotes.json
Perbandingan bersebelahan
| BeautifulSoup | Scrapy | |
|---|---|---|
| Jenis | Pustaka penghurai HTML | Rangka kerja merangkak lengkap |
| Keluk pembelajaran | Sangat landai | Sederhana |
| Memuat turun halaman | Tidak, perlukan Requests atau httpx | Ya, terbina dalam |
| Kelajuan untuk banyak halaman | Perlahan kecuali anda menambah keserentakan sendiri | Pantas, tak segerak secara lalai |
| Mengikut pautan | Manual | Terbina dalam |
| Eksport data | Manual | JSON, CSV dan XML terbina dalam |
| Pendikitan dan cubaan semula | Manual | Terbina dalam |
| Halaman dijana JavaScript | Tidak | Tidak, perlukan tambahan |
| Terbaik untuk | Skrip kecil dan tugasan sekali sahaja | Rangkakan besar atau berulang |
Bila memilih BeautifulSoup
- Anda perlukan data daripada beberapa halaman sahaja, atau scraping sekali sahaja.
- Anda sedang belajar web scraping atau Python.
- Anda sudah mempunyai HTML, contohnya daripada respons API, e-mel atau fail yang disimpan, dan hanya perlu menghurainya.
- Anda mahu menambah langkah scraping kecil dalam skrip atau aplikasi sedia ada.
Bila memilih Scrapy
- Anda perlu merangkak ratusan atau ribuan halaman.
- Scraper akan dijalankan secara berkala dan mesti boleh dipercayai.
- Anda perlu mengikut penomboran halaman dan pautan di seluruh laman.
- Data mesti dibersihkan, disahkan dan disimpan secara berstruktur.
- Anda mahu kawalan adab terbina dalam supaya tidak membebankan laman sasaran.
Bagaimana dengan laman web yang banyak JavaScript?
BeautifulSoup mahupun Scrapy tidak menjalankan JavaScript. Jika kandungan yang anda perlukan dimuatkan oleh JavaScript selepas halaman dibuka, anda ada dua pilihan:
- Cari permintaan API yang dibuat oleh halaman dalam alat pembangun pelayar anda. Memanggil titik akhir JSON itu secara langsung biasanya lebih pantas dan stabil daripada scraping HTML.
- Gunakan pelayar tanpa kepala seperti Playwright atau Selenium. Playwright boleh digabungkan dengan Scrapy melalui pemalam
scrapy-playwright, atau digunakan sendiri bersama BeautifulSoup untuk penghuraian.
Bolehkah kedua-duanya digunakan bersama?
Boleh. Scrapy mempunyai pemilih pantas sendiri, tetapi tiada halangan untuk menghantar respons kepada BeautifulSoup dalam callback Scrapy jika anda lebih suka API-nya. Banyak pasukan membina prototaip dengan Requests dan BeautifulSoup, kemudian beralih ke Scrapy apabila tugas perlu diskalakan.
Scraping secara bertanggungjawab
Mampu melakukan scraping pada sesebuah laman tidak bermakna anda dibenarkan. Sebelum bermula:
- Baca terma perkhidmatan laman dan hormati fail robots.txt-nya.
- Hadkan kadar permintaan supaya laman tidak menjadi perlahan untuk pelawat sebenar.
- Jangan kumpul data peribadi tanpa asas undang-undang. Undang-undang seperti GDPR dan PDPA turut terpakai pada data hasil scraping.
- Utamakan API rasmi jika ada.
Keputusan
Untuk belajar, projek kecil dan pengekstrakan data pantas, BeautifulSoup ialah titik permulaan terbaik: ringkas, bertoleransi dan mudah dibaca. Untuk apa-apa yang besar, berulang atau kritikal kepada perniagaan, Scrapy ialah alat yang lebih baik, kerana ia memberi kelajuan, struktur dan kawalan adab yang sebaliknya perlu anda bina sendiri.
Jika data hasil scraping perlu dimasukkan ke papan pemuka, CRM atau ERP anda sendiri, scraper hanyalah satu bahagian sistem. Di ArtinTech Solution, kami membina sistem dalaman tersuai dan aplikasi web yang mengumpul, mengesahkan dan menggunakan data seperti ini. Ceritakan projek anda.
Soalan lazim
Adakah Scrapy lebih pantas daripada BeautifulSoup?
Untuk merangkak banyak halaman, ya, kerana Scrapy menghantar permintaan serentak manakala skrip asas Requests dan BeautifulSoup mengambil satu halaman pada satu masa. Untuk menghurai satu dokumen, perbezaannya kecil.
Adakah BeautifulSoup sesuai untuk pemula?
Ya. Ia salah satu cara paling mudah untuk mempelajari struktur HTML dan cara mengekstrak data daripadanya dengan Python.
Bolehkah Scrapy melakukan scraping pada laman JavaScript?
Tidak dengan sendirinya. Gunakan API asas laman jika boleh, atau tambah pelayar tanpa kepala melalui pemalam scrapy-playwright.
Adakah web scraping sah di sisi undang-undang?
Ia bergantung pada terma laman, jenis data dan undang-undang di negara anda. Scraping data awam yang bukan peribadi secara sederhana biasanya berisiko lebih rendah, tetapi sentiasa semak terma dan dapatkan nasihat undang-undang untuk projek komersial.