🌐 Lire cet article dans une autre langue : English · Español · Deutsch · Français · Bahasa Melayu · العربية · 简体中文 · 日本語
Le web scraping consiste à extraire automatiquement des données de sites web, pour la recherche, la veille tarifaire, des listes de prospects, l’analyse de marché ou pour alimenter des systèmes internes. En Python, deux outils dominent le sujet : BeautifulSoup et Scrapy.
On les compare souvent comme s’ils étaient concurrents, mais ils résolvent des problèmes différents. BeautifulSoup est une bibliothèque d’analyse HTML. Scrapy est un framework complet pour explorer des sites à grande échelle. Ce guide explique la différence avec du vrai code et vous aide à choisir le bon outil pour votre projet.
Qu’est-ce que BeautifulSoup ?
BeautifulSoup (le paquet bs4) lit un document HTML ou XML et le transforme en arbre que vous parcourez avec des méthodes Python simples comme find(), find_all() et des sélecteurs CSS via select(). Il ne télécharge pas les pages lui-même : il est donc presque toujours associé à une bibliothèque HTTP comme Requests.
- Très facile à apprendre, même pour les débutants en Python.
- Tolérant avec le HTML désordonné ou mal formé.
- Compatible avec plusieurs analyseurs :
html.parserintégré,lxmlrapide, ouhtml5libpour une analyse proche d’un navigateur. - Idéal pour les petits scripts et les tâches ponctuelles.
Qu’est-ce que Scrapy ?
Scrapy est un framework open source pour créer des robots d’exploration, appelés spiders. Il gère tout le processus : envoyer les requêtes, suivre les liens, analyser les réponses, nettoyer les données et les exporter.
- Asynchrone par conception. Scrapy envoie de nombreuses requêtes en parallèle, ce qui le rend bien plus rapide sur les gros sites.
- Courtoisie intégrée. Respect du robots.txt, AutoThrottle, délais de téléchargement et nouvelles tentatives sont de simples réglages.
- Les item pipelines nettoient, valident et enregistrent les données dans une base ou un fichier.
- Les feed exports écrivent du JSON, du CSV ou du XML en une seule commande.
- Les middlewares permettent de personnaliser les en-têtes, les proxys, le cache et la gestion des erreurs.
Le même scraper avec les deux outils
L’exemple ci-dessous récupère toutes les citations et leurs auteurs sur quotes.toscrape.com, un site conçu pour s’entraîner au scraping. À gauche, Requests avec BeautifulSoup ; à droite, un spider Scrapy.
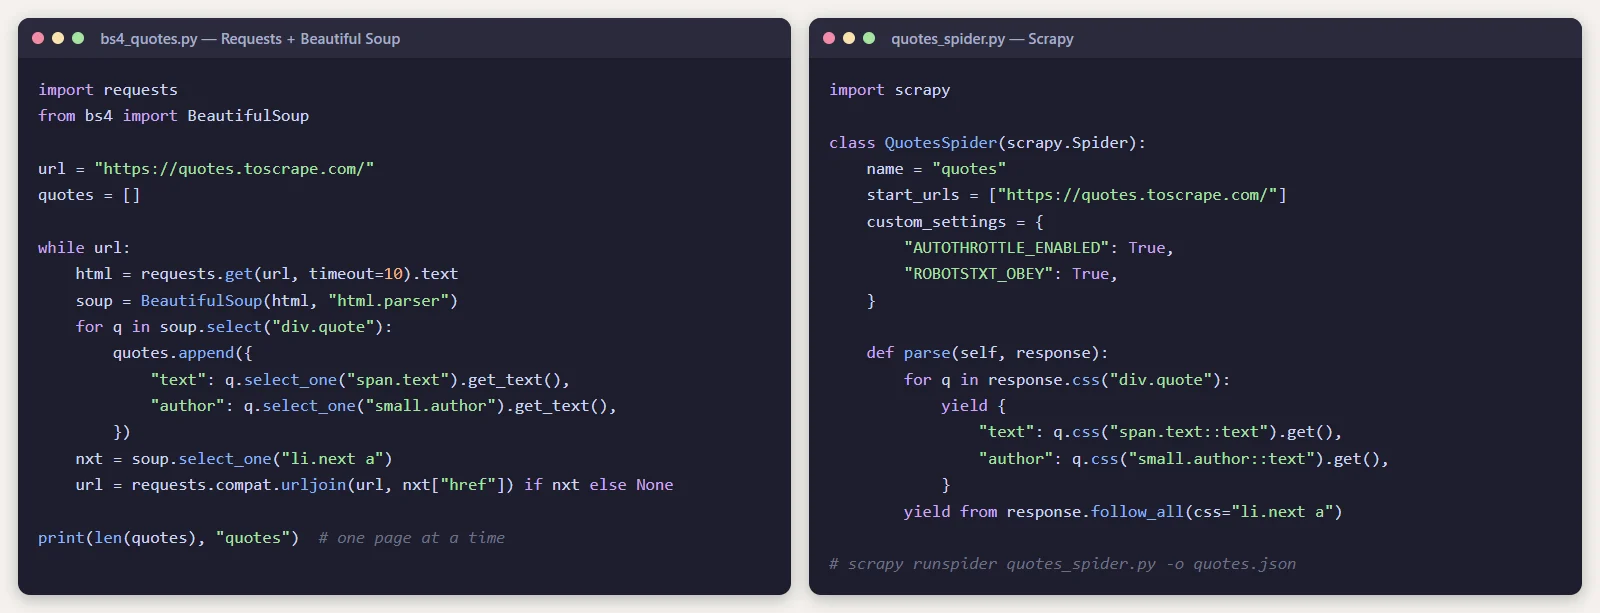
Les deux produisent les mêmes données. La différence apparaît quand la tâche grossit : le script BeautifulSoup attend chaque page avant de demander la suivante, alors que Scrapy télécharge de nombreuses pages en parallèle et gère pour vous les nouvelles tentatives, la limitation de débit et l’export.
Pour les essayer vous-même :
pip install requests beautifulsoup4
python bs4_quotes.py

pip install scrapy
scrapy runspider quotes_spider.py -o quotes.json
Comparatif côte à côte
| BeautifulSoup | Scrapy | |
|---|---|---|
| Type | Bibliothèque d’analyse HTML | Framework d’exploration complet |
| Courbe d’apprentissage | Très douce | Moyenne |
| Télécharge les pages | Non, nécessite Requests ou httpx | Oui, intégré |
| Vitesse sur beaucoup de pages | Lente sans concurrence ajoutée par vous | Rapide, asynchrone par défaut |
| Suivi des liens | Manuel | Intégré |
| Export des données | Manuel | JSON, CSV et XML intégrés |
| Limitation de débit et nouvelles tentatives | Manuelles | Intégrées |
| Pages rendues en JavaScript | Non | Non, nécessite un module |
| Idéal pour | Petits scripts et tâches ponctuelles | Explorations importantes ou récurrentes |
Quand choisir BeautifulSoup
- Vous avez besoin des données de quelques pages, ou vous ne scrapez qu’une fois.
- Vous apprenez le web scraping ou Python.
- Vous avez déjà le HTML, par exemple issu d’une réponse d’API, d’un e-mail ou d’un fichier enregistré, et il suffit de l’analyser.
- Vous voulez ajouter une petite étape de scraping dans un script ou une application existants.
Quand choisir Scrapy
- Vous devez explorer des centaines ou des milliers de pages.
- Le scraper tournera régulièrement et doit être fiable.
- Vous devez suivre la pagination et les liens sur tout un site.
- Les données doivent être nettoyées, validées et stockées de façon structurée.
- Vous voulez des contrôles de courtoisie intégrés pour ne pas surcharger le site cible.
Et les sites très chargés en JavaScript ?
Ni BeautifulSoup ni Scrapy n’exécutent le JavaScript. Si le contenu voulu est chargé par JavaScript après l’ouverture de la page, vous avez deux options :
- Cherchez dans les outils de développement de votre navigateur la requête d’API effectuée par la page. Appeler directement ce point d’accès JSON est généralement plus rapide et plus stable que de scraper le HTML.
- Utilisez un navigateur sans interface comme Playwright ou Selenium. Playwright peut être combiné à Scrapy grâce au plugin
scrapy-playwright, ou utilisé seul avec BeautifulSoup pour l’analyse.
Peut-on utiliser les deux ensemble ?
Oui. Scrapy dispose de ses propres sélecteurs rapides, mais rien ne vous empêche de passer une réponse à BeautifulSoup dans un callback Scrapy si vous préférez son API. Beaucoup d’équipes prototypent avec Requests et BeautifulSoup, puis passent à Scrapy quand la tâche doit monter en charge.
Scraper de façon responsable
Pouvoir scraper un site ne signifie pas en avoir le droit. Avant de commencer :
- Lisez les conditions d’utilisation du site et respectez son fichier robots.txt.
- Limitez la fréquence de vos requêtes pour ne jamais ralentir le site pour ses vrais visiteurs.
- Ne collectez pas de données personnelles sans base légale. Des lois comme le RGPD s’appliquent aussi aux données scrapées.
- Privilégiez une API officielle quand elle existe.
Le verdict
Pour apprendre, pour les petits projets et les extractions rapides, BeautifulSoup est le meilleur point de départ : simple, tolérant et facile à lire. Pour tout ce qui est volumineux, récurrent ou critique pour l’activité, Scrapy est le meilleur outil, car il apporte vitesse, structure et contrôles de courtoisie que vous devriez sinon développer vous-même.
Si les données collectées doivent finir dans vos propres tableaux de bord, votre CRM ou votre ERP, le scraper n’est qu’une partie du système. Chez ArtinTech Solution, nous développons des systèmes internes sur mesure et des applications web qui collectent, valident et exploitent ce type de données. Parlez-nous de votre projet.
Questions fréquentes
Scrapy est-il plus rapide que BeautifulSoup ?
Pour explorer beaucoup de pages, oui, car Scrapy envoie les requêtes en parallèle alors qu’un script basique Requests et BeautifulSoup télécharge une page à la fois. Pour analyser un seul document, la différence est faible.
BeautifulSoup convient-il aux débutants ?
Oui. C’est l’un des moyens les plus simples d’apprendre comment le HTML est structuré et comment en extraire des données avec Python.
Scrapy peut-il scraper des sites en JavaScript ?
Pas tout seul. Utilisez l’API sous-jacente du site si possible, ou ajoutez un navigateur sans interface via le plugin scrapy-playwright.
Le web scraping est-il légal ?
Cela dépend des conditions d’utilisation du site, du type de données et des lois de votre pays. Scraper avec modération des données publiques et non personnelles est généralement moins risqué, mais vérifiez toujours les conditions et demandez un avis juridique pour les projets commerciaux.