🌐 Diesen Artikel in einer anderen Sprache lesen: English · Español · Deutsch · Français · Bahasa Melayu · العربية · 简体中文 · 日本語
Web Scraping ist das automatische Extrahieren von Daten aus Websites – für Recherche, Preisbeobachtung, Lead-Listen, Marktanalysen oder um interne Systeme mit Daten zu versorgen. In Python dominieren zwei Tools die Diskussion: BeautifulSoup und Scrapy.
Sie werden oft verglichen, als wären sie Konkurrenten, lösen aber unterschiedliche Probleme. BeautifulSoup ist eine Bibliothek zum Parsen von HTML. Scrapy ist ein vollständiges Framework zum Crawlen von Websites im großen Maßstab. Dieser Ratgeber erklärt den Unterschied mit echtem Code und hilft Ihnen, das richtige Tool für Ihr Projekt zu wählen.
Was ist BeautifulSoup?
BeautifulSoup (das Paket bs4) liest ein HTML- oder XML-Dokument ein und wandelt es in einen Baum um, den Sie mit einfachen Python-Methoden wie find(), find_all() und CSS-Selektoren über select() durchsuchen können. Seiten lädt es nicht selbst herunter, daher wird es fast immer mit einer HTTP-Bibliothek wie Requests kombiniert.
- Sehr leicht zu lernen, auch für Python-Einsteiger.
- Tolerant gegenüber unsauberem, fehlerhaftem HTML.
- Arbeitet mit verschiedenen Parsern: dem integrierten
html.parser, dem schnellenlxmloderhtml5libfür browserähnliches Parsen. - Ideal für kleine Skripte und einmalige Aufgaben.
Was ist Scrapy?
Scrapy ist ein Open-Source-Framework zum Bau von Webcrawlern, sogenannten Spiders. Es übernimmt den gesamten Ablauf: Anfragen senden, Links folgen, Antworten parsen, Daten bereinigen und exportieren.
- Asynchron von Grund auf. Scrapy sendet viele Anfragen gleichzeitig und ist dadurch auf großen Websites deutlich schneller.
- Eingebaute Rücksichtnahme. robots.txt beachten, AutoThrottle, Download-Verzögerungen und Wiederholungsversuche sind einfache Einstellungen.
- Item Pipelines bereinigen, validieren und speichern Daten in einer Datenbank oder Datei.
- Feed Exports schreiben JSON, CSV oder XML mit einem einzigen Befehl.
- Middlewares erlauben individuelle Header, Proxys, Caching und Fehlerbehandlung.
Derselbe Scraper mit beiden Tools
Das folgende Beispiel sammelt alle Zitate und Autoren von quotes.toscrape.com, einer Website zum Üben von Web Scraping. Links Requests mit BeautifulSoup, rechts ein Scrapy-Spider.
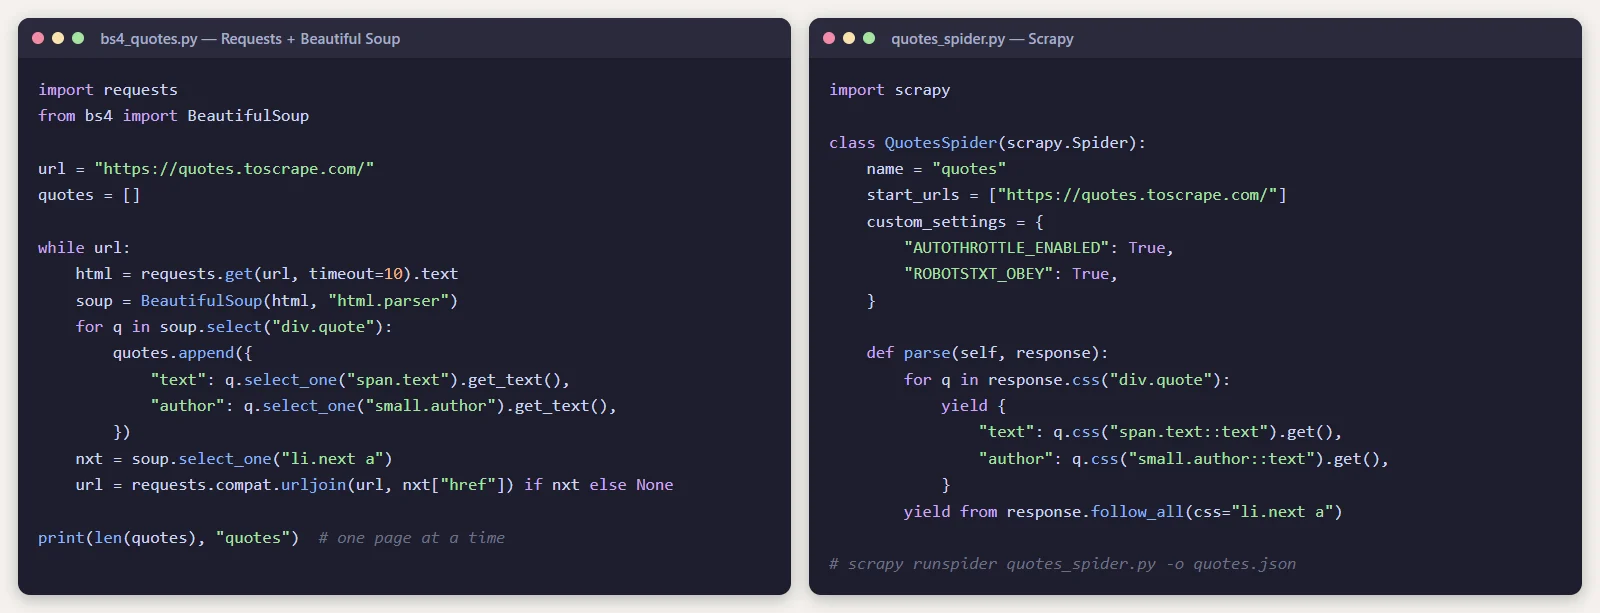
Beide liefern dieselben Daten. Der Unterschied zeigt sich, wenn die Aufgabe wächst: Das BeautifulSoup-Skript wartet auf jede Seite, bevor es die nächste anfordert, während Scrapy viele Seiten parallel lädt und Wiederholungen, Drosselung und Export für Sie übernimmt.
So probieren Sie es selbst aus:
pip install requests beautifulsoup4
python bs4_quotes.py

pip install scrapy
scrapy runspider quotes_spider.py -o quotes.json
Direkter Vergleich
| BeautifulSoup | Scrapy | |
|---|---|---|
| Typ | HTML-Parsing-Bibliothek | Vollständiges Crawling-Framework |
| Lernkurve | Sehr flach | Mittel |
| Lädt Seiten herunter | Nein, braucht Requests oder httpx | Ja, integriert |
| Tempo bei vielen Seiten | Langsam, wenn Sie keine Nebenläufigkeit ergänzen | Schnell, standardmäßig asynchron |
| Links folgen | Manuell | Integriert |
| Datenexport | Manuell | JSON, CSV und XML integriert |
| Drosselung und Wiederholungen | Manuell | Integriert |
| JavaScript-gerenderte Seiten | Nein | Nein, braucht eine Erweiterung |
| Am besten für | Kleine Skripte und einmalige Aufgaben | Große oder wiederkehrende Crawls |
Wann Sie BeautifulSoup wählen sollten
- Sie brauchen Daten von wenigen Seiten oder scrapen nur einmal.
- Sie lernen gerade Web Scraping oder Python.
- Sie haben das HTML bereits, etwa aus einer API-Antwort, einer E-Mail oder einer gespeicherten Datei, und müssen es nur parsen.
- Sie möchten einen kleinen Scraping-Schritt in ein bestehendes Skript oder eine Anwendung einbauen.
Wann Sie Scrapy wählen sollten
- Sie müssen Hunderte oder Tausende Seiten crawlen.
- Der Scraper läuft regelmäßig und muss zuverlässig sein.
- Sie müssen Paginierung und Links über eine ganze Website verfolgen.
- Die Daten müssen bereinigt, validiert und strukturiert gespeichert werden.
- Sie möchten eingebaute Rücksichtnahme, damit die Zielseite nicht überlastet wird.
Und JavaScript-lastige Websites?
Weder BeautifulSoup noch Scrapy führen JavaScript aus. Wenn die benötigten Inhalte erst nach dem Öffnen der Seite per JavaScript geladen werden, haben Sie zwei Möglichkeiten:
- Suchen Sie in den Entwicklertools Ihres Browsers nach der API-Anfrage, die die Seite stellt. Diesen JSON-Endpunkt direkt abzufragen ist meist schneller und stabiler, als HTML zu scrapen.
- Nutzen Sie einen Headless-Browser wie Playwright oder Selenium. Playwright lässt sich über das Plugin
scrapy-playwrightmit Scrapy kombinieren oder eigenständig mit BeautifulSoup zum Parsen verwenden.
Kann man beide zusammen nutzen?
Ja. Scrapy hat eigene schnelle Selektoren, aber nichts hindert Sie daran, eine Antwort innerhalb eines Scrapy-Callbacks an BeautifulSoup zu übergeben, wenn Sie dessen API bevorzugen. Viele Teams bauen den Prototyp mit Requests und BeautifulSoup und wechseln zu Scrapy, sobald die Aufgabe skalieren muss.
Verantwortungsvoll scrapen
Dass Sie eine Website scrapen können, heißt nicht, dass Sie es dürfen. Bevor Sie beginnen:
- Lesen Sie die Nutzungsbedingungen der Website und respektieren Sie ihre robots.txt.
- Begrenzen Sie Ihre Anfragerate, damit die Website für echte Besucher nie langsamer wird.
- Erheben Sie keine personenbezogenen Daten ohne Rechtsgrundlage. Gesetze wie die DSGVO gelten auch für gescrapte Daten.
- Nutzen Sie eine offizielle API, wenn es eine gibt.
Das Fazit
Zum Lernen, für kleine Projekte und schnelle Datenextraktion ist BeautifulSoup der beste Einstieg: einfach, fehlertolerant und gut lesbar. Für alles, was groß, wiederkehrend oder geschäftskritisch ist, ist Scrapy das bessere Tool, weil es Geschwindigkeit, Struktur und Rücksichtnahme mitbringt, die Sie sonst selbst bauen müssten.
Wenn gescrapte Daten in Ihren eigenen Dashboards, Ihrem CRM oder ERP landen sollen, ist der Scraper nur ein Teil des Systems. Bei ArtinTech Solution entwickeln wir individuelle interne Systeme und Webanwendungen, die solche Daten erfassen, validieren und nutzen. Erzählen Sie uns von Ihrem Projekt.
Häufige Fragen
Ist Scrapy schneller als BeautifulSoup?
Beim Crawlen vieler Seiten ja, weil Scrapy Anfragen gleichzeitig sendet, während ein einfaches Skript mit Requests und BeautifulSoup eine Seite nach der anderen lädt. Beim Parsen eines einzelnen Dokuments ist der Unterschied gering.
Ist BeautifulSoup gut für Einsteiger?
Ja. Es ist einer der einfachsten Wege zu lernen, wie HTML aufgebaut ist und wie man mit Python Daten daraus extrahiert.
Kann Scrapy JavaScript-Websites scrapen?
Nicht allein. Nutzen Sie nach Möglichkeit die zugrunde liegende API der Website oder ergänzen Sie einen Headless-Browser über das Plugin scrapy-playwright.
Ist Web Scraping legal?
Das hängt von den Nutzungsbedingungen der Website, der Art der Daten und den Gesetzen in Ihrem Land ab. Öffentliche, nicht personenbezogene Daten zurückhaltend zu scrapen ist in der Regel risikoärmer, aber prüfen Sie immer die Bedingungen und holen Sie bei kommerziellen Projekten rechtlichen Rat ein.